


Dimineața în care graficul nu mai spunea nimic.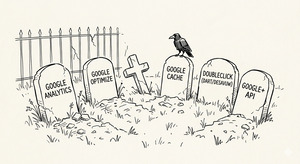
Există un moment pe care orice om care lucrează serios cu date digitale l-a trăit cel puțin o dată: te uiți la un grafic pe care îl cunoști ca pe buzunarul tău și ceva nu se potrivește. Nu e o scădere dramatică, nu e o alarmă roșie — e o ușoară disproporție, un număr care pare prea rotund, o curbă care merge prea lin. Un instinct înainte de a fi o concluzie.
În septembrie 2025, mii de specialiști SEO din întreaga lume au trăit simultan această senzație. Impresiile din Google Search Console scăzuseră brusc cu 20, 30, uneori 50 de procente — fără nicio modificare în conținut, fără nicio penalizare algoritmică, fără niciun anunț oficial. Clickurile rămâneau stabile. Veniturile din trafic organic nu se clintiseră. Pozițiile reale în rezultatele de căutare erau aceleași ca în ziua precedentă.
Ce dispăruse nu era vizibilitatea site-urilor. Dispăruseră impresiile fabricate de boți și scrapere care, ani la rând, umflaseră sistematic unul dintre indicatorii centrali ai raportării SEO — fără ca Google să fi semnalat vreodată această problemă.
Și asta era abia al doilea act al poveștii.
Primul act se terminase în tăcere, în ianuarie 2024, când Google retrăsese din Search Console un instrument prezent acolo de 15 ani — Crawl Rate Limiter Tool — cu o notă de două paragrafe și fără niciun fel de dezbatere publică. Al treilea act, cel mai grav, urma să fie descoperit abia pe 30 martie 2026, de un consultant australian care observase ceva ciudat în spike-urile de impresii desktop. Patru zile mai târziu, Google confirma: o eroare de logging făcuse ca Search Console să raporteze incorect impresiile timp de 50 de săptămâni consecutive.
Un an. Aproape un an calendaristic complet de date compromise. Descoperite nu de Google, ci de comunitate.
Acesta nu este un articol despre un bug. Este un articol despre un model. Un model pe care Google îl repetă cu o consecvență care ar trebui să fie, la un moment dat, un semnal de alarmă pentru oricine construiește decizii de afaceri pe datele furnizate de platformele sale.
Instrumentul care a stat 15 ani în sertar fără să fie folosit
Să începem de la capăt, adică de la cel mai nevinovat dintre semnale.
Pe 8 ianuarie 2024, Google a anunțat retragerea Crawl Rate Limiter Tool din Search Console. Instrumentul fusese introdus în 2008 — acum 18 ani față de momentul scrierii acestor rânduri — cu un scop precis și legitim: permitea proprietarilor de site-uri să ceară Googlebot să reducă ritmul de crawlare atunci când serverele lor erau supraîncărcate. Idee bună, implementare logică, utilitate reală la momentul lansării.
Gary Illyes, reprezentant Google în comunitatea webmasterilor, a explicat retragerea cu o onestitate dezarmantă: algoritmii de crawling s-au îmbunătățit suficient încât Googlebot reacționează automat la semnalele serverului. Dacă primește erori sau timpi de răspuns crescuți, reduce singur ritmul — aproape imediat. Instrumentul manual, în schimb, putea dura peste o zi pentru a aplica setările. Iar cei care îl foloseau, în marea lor majoritate, setau viteza la minimum absolut — din precauție excesivă sau din lipsă de înțelegere a mecanismului.
Deci: un instrument care funcționa prost, era rar folosit și era de mult depășit de propria sa logică internă. Până aici, nimic dramatic.
Dar stați o clipă cu această imagine: un instrument care stă 15 ani într-o interfață folosită de milioane de webmasteri, despre care Google știa că e rar folosit și lent, și pe care l-a lăsat acolo din inerție instituțională — nu din utilitate. Câte alte lucruri mai stau la fel în Search Console? Câte instrumente mai există acolo pentru că nimeni nu a decis încă să le scoată, nu pentru că mai au vreo valoare reală?
Aceasta este prima fisură în ceea ce eu numesc iluzia oficialității: convingerea tacită că dacă un instrument se află pe o platformă Google, este acolo pentru că funcționează, pentru că e corect, pentru că merită încredere. Crawl Rate Limiter a demonstrat că instrumentele pot supraviețui mult peste utilitatea lor, nu prin valoare, ci prin neglijare.
Datele care nu existau: povestea parametrului &num=100
Acum ajungem la miezul problemei. Și miezul arată urât.
Timp de cel puțin câțiva ani înainte de septembrie 2025, Google Search Console a raportat impresii pentru pagini care nu fuseseră văzute de niciun utilizator real. Impresiile respective proveneau din activitatea boților, a scraperelor și a instrumentelor de rank-tracking care foloseau un parametru tehnic — &num=100 — ce permitea afișarea a 100 de rezultate de căutare pe o singură pagină, în loc de cele standard 10.
Mecanismul era simplu: în loc să pagineze prin zece pagini pentru a colecta pozițiile 1–100, un tool de monitorizare putea recupera totul dintr-o singură interogare. Eficient pentru mașini. Invizibil pentru utilizatorul uman real, care nu a văzut niciodată acele 100 de rezultate pe pagină.
Pe 12–14 septembrie 2025, Google a dezactivat parametrul. Fără anunț prealabil. Fără perioadă de tranziție. Pur și simplu a încetat să mai funcționeze.
Efectul a fost imediat și, pentru mulți, înspăimântător: impresiile au scăzut precipitat, graficele arătau un colaps vertical, iar specialiștii SEO din toată lumea au intrat în panică. Termenul folosit în comunitate a fost alligator effect — pe graficele din lunile precedente se vedea o foarfecă în expansiune între impresii (care crescuseră constant) și clickuri (care rămâneau plate). Ca gura deschisă a unui aligator. O anomalie vizibilă cu luni înainte de intervenția Google — și pe care nimeni din echipele oficiale nu o semnalase.
Aici e locul unde trebuie să ne oprim și să punem întrebarea incomodă.
Dacă datele dintr-un instrument oficial au inclus ani la rând activitate non-umană ca și cum ar fi fost activitate reală — ce valoare aveau rapoartele pe care le-am livrat clienților în toți acei ani? Ce valoare aveau comparațiile an-la-an construite pe aceste impresii? Ce valoare aveau strategiile de conținut justificate cu creșteri de vizibilitate care, parțial, nu existau?
Răspunsul sincer este: mai puțin decât credeam. Poate mult mai puțin.
Nu spun că totul era fals. Clickurile erau reale. Pozițiile erau reale. Traficul din GA era real. Dar impresiile — metrica pe care o foloseam cel mai frecvent pentru a demonstra creșterea vizibilității unui site — conțineau un nivel de zgomot pe care nu l-am putut măsura niciodată, pentru că nu știam că există.
Și Google știa? Sau nu știa? Oricare dintre variante este îngrijorătoare în felul ei.
Cincizeci de săptămâni de tăcere
Dacă primele două semnale pot fi integrate, cu bunăvoință și efort interpretativ, într-o narațiune despre evoluția normală a platformelor tehnice — cel de-al treilea nu mai permite această generozitate.
O eroare de logging în sistemul intern al Google a făcut ca Search Console să supranumere impresiile timp de 50 de săptămâni consecutive — de la 13 mai 2025 până la 27 aprilie 2026. Au fost afectate toate tipurile de căutare: web search, mobile, image search, merchant listings, job listings.
Consecințele nu s-au oprit la impresii. CTR-ul — rata de click-through, indicatorul pe care îl folosim pentru a evalua relevanța titlurilor și meta-descrierilor față de intenția utilizatorilor — se calculează ca raport între clickuri și impresii. Dacă numitorul e greșit, raportul e greșit. La fel și poziția medie. Orice audit SEO livrat în aceste 50 de săptămâni care s-a bazat pe aceste metrici a fost construit pe un fundament incorect.
Dar detaliul care m-a oprit în loc, când am citit prima analiză serioasă despre această situație, nu a fost dimensiunea erorii. A fost cine a descoperit-o.
Nu Google. Nu o echipă internă de quality assurance. Nu un sistem automat de monitorizare a anomaliilor de date.
Bug-ul a fost identificat de Brodie Clark, un consultant SEO independent din Australia, care pe 30 martie 2026 a publicat pe LinkedIn o analiză a anomaliilor observate în spike-urile de impresii desktop — în special pentru secțiunea de merchant listings. Patru zile mai târziu, Google a confirmat problema printr-o notă minimală pe pagina sa de anomalii de date.
Două rânduri. Pentru aproape un an de date compromise.
Există un proverb românesc pe care mi l-a repetat tatăl meu de câte ori mă grăbeam să dau vina pe altul: „Cine se scuză, se acuză." Dar există și reversul: tăcerea în fața unei probleme pe care ar fi trebuit să o descoperi tu însuți nu este nevinovăție. Este, în cel mai bun caz, neglijență organizațională. În cel mai rău caz, este ceva pe care nu vreau să-l numesc.
Cimitirul instrumentelor Google: un model, nu o excepție
Să facem un pas înapoi și să privim tabloul de ansamblu. Pentru că ceea ce s-a întâmplat cu Search Console nu este singular. Este parte dintr-un model pe care Google îl repetă cu o regularitate pe care comunitatea tehnică o numește, cu ironie afectuoasă, Google Graveyard — cimitirul produselor Google.
Universal Analytics a fost retras în iulie 2024, după 12 ani de utilizare activă. Milioane de site-uri din întreaga lume aveau ani de date istorice stocate în platformă. Avertizarea a venit cu un an înainte — pare suficient, dar termenele au fost modificate de două ori — iar datele care nu au fost exportate manual înainte de data limită au fost șterse definitiv și irecuperabil. Nu există backup, nu există excepție, nu există apel.
Câte agenții din România au exportat complet datele Universal Analytics înainte de iulie 2024? Câți clienți au pierdut ani de date analitice pentru că nimeni nu i-a avertizat la timp? Mă îndoiesc că există statistici. Știu că există regrete.
Google Optimize — instrumentul de A/B testing pe care mii de echipe de marketing îl integraseră în fluxurile lor de lucru — a fost eliminat pe 30 septembrie 2023, cu o promisiune vagă că Google va „investi în A/B testing în Google Analytics 4". Promisiunea a rămas vagă doi ani. În 2025, a apărut în documentația internă a Google ceva ce pare a fi un instrument de experimentare nou — fără screenshot-uri publice, fără lansare anunțată, fără nicio garanție că va ajunge vreodată la utilizatorul obișnuit.
Google Cache — una dintre cele mai vechi funcții ale motorului de căutare, activă din 2001 — a dispărut în etape pe parcursul anului 2024, fără o perioadă de tranziție reală. Danny Sullivan, Search Liaison Google, a recunoscut public că îi pare rău de dispariție: „E una dintre cele mai vechi funcții ale noastre." Dar regretul nu aduce înapoi instrumentul de diagnosticare pe care SEO-știi îl foloseau pentru a vedea cum indexase Google o pagină, pentru a identifica discrepanțe de conținut, pentru a detecta penalizări. Acum, singura alternativă oficială rămasă pentru acest tip de diagnosticare este... instrumentul de inspecție URL din Search Console. Același Search Console care tocmai terminase 50 de săptămâni de date incorecte.
Disavow Tool — tot din Search Console — a fost anunțat informal ca potențial candidat la eliminare de John Mueller: „La un moment dat, sunt sigur că îl vom elimina." Nicio dată. Niciun calendar. Suspendare instituțională la nesfârșit.
Iar API-ul Google Search Console conectat la Looker Studio a blocat furnizarea de date în iunie 2025, în aprilie 2025, în februarie 2025 și în decembrie 2023 — de patru ori în mai puțin de doi ani. De fiecare dată, problema a fost identificată de utilizatori, raportată în forumuri, rezolvată cu întârziere. De fiecare dată, dashboard-urile de raportare au afișat date incomplete sau deloc, fără nicio alertă automată care să avertizeze utilizatorul că ce vede nu mai reflectă realitatea.
Tabloul complet: ce s-a eliminat și când
| Instrument | Activ de | Eliminat / degradat | Avertizare reală |
|---|---|---|---|
| Universal Analytics | 2005 | iulie 2024 | 1 an (cu modificări de termen) |
| Google Optimize | 2017 | sept. 2023 | 8 luni, fără înlocuitor clar |
| Google Cache | 2001 | sept. 2024 | câteva săptămâni |
| GSC Crawl Rate Limiter | 2008 | ian. 2024 | 2 luni |
| GSC Disavow Tool | 2012 | anunțat, nedatat | — |
| GSC bug 50 săptămâni | — | mai 2025–apr. 2026 | zero |
| GSC API Looker Studio | — | blocaje repetate 2023–2025 | zero |
Privind acest tabel, întrebarea care se pune singură este: de ce continuăm să tratăm datele Google ca pe un reper absolut?
Iluzia oficialității și prețul ei
Există o credință adânc înrădăcinată în industria digitală — și în rândul clienților care comandă servicii digitale — că dacă vine de la Google, e corect. Această credință are o logică: Google este compania care a construit cel mai folosit motor de căutare din lume, care procesează miliarde de interogări zilnic, care angajează unii dintre cei mai buni ingineri software de pe planetă. Cum ar putea o astfel de companie să furnizeze date incorecte?
Ușor. Prin același mecanism prin care orice sistem complex la scară mare furnizează date incorecte: prin erori de logging nedetectate, prin parametri tehnici exploatați de actori externi, prin instrumente lăsate să ruginească, prin decizii de produs comunicate insuficient sau deloc.
Haina nu face pe om — și sigla nu face datele corecte. Un număr dintr-un dashboard oficial nu devine adevărat prin faptul că are sigla Google deasupra. Devine adevărat dacă rezistă la triangulare, dacă se corelează cu alte surse, dacă reflectă o realitate observabilă și în alte instrumente.
Problema este că industria SEO și marea majoritate a agențiilor web au construit sisteme de raportare care tratează GSC ca pe o sursă unică de adevăr. Raportul lunar merge direct din Export CSV al Google Search Console în slide-ul pentru client. Nimeni nu verifică dacă clickurile din GSC corelează cu sesiunile organice din GA4. Nimeni nu compară tendințele cu Bing Webmaster Tools. Nimeni nu încrucișează impresiile cu datele din rank-trackerele independente.
De ce? Nu din lipsă de cunoaștere tehnică. Din confort. Din eficiență aparentă. Din lene mascată în încredere.
Și asta, în lumina celor 50 de săptămâni de date false, nu mai este o scăpare acceptabilă.
Responsabilitatea care nu se poate delega
Vreau să fiu precis aici, pentru că subiectul are tentația de a aluneca în critică facilă la adresa Google și de a absolvi pe toată lumea de responsabilitate.
Google a greșit. Dar greșeala Google nu acoperă greșeala noastră — a agențiilor, a consultanților, a tuturor celor care am livrat rapoarte bazate pe o singură sursă de date fără să punem niciodată întrebarea: ce se întâmplă dacă sursa asta e greșită?
Există în România un mod de a spune lucrurile pe șleau pe care îl apreciez: „Prostul nu e de vină că e prost, dar dacă stă prost e de vină." Nimeni nu știa în 2022 că GSC va acumula un bug de un an în 2025. Dar știam — sau ar fi trebuit să știm — că orice sistem tehnic poate eșua. Știam că datele digitale sunt, prin natura lor, estimări și proxy-uri, nu adevăruri absolute. Știam că triangularea este o practică de bază în orice metodologie de cercetare serioasă.
Dacă un client a luat decizia de a reduce bugetul de conținut pentru că „impresiile au scăzut" — impresii care se vor fi dovedit ulterior a fi fost inflate de 50 de săptămâni de bug — cineva a livrat o recomandare greșită. Acel cineva nu era neapărat rău intenționat. Dar era, cu certitudine, insuficient de riguros.
Acesta este miezul dur al problemei: a livra rapoarte bazate pe o singură sursă de date, fără triangulare, fără verificare critică, nu este o greșeală tehnică — este o alegere de comoditate. Iar alegerile de comoditate au consecințe reale pentru oamenii reali care plătesc facturi reale pe baza concluziilor din acele rapoarte.
Ce înseamnă triangularea în practică — și de ce nu se face
Triangularea nu este un concept exotic. Este ceea ce face orice jurnalist serios înainte să publice o știre: confirmă informația din cel puțin două surse independente. Este ceea ce face orice medic serios înainte să pună un diagnostic: corelează simptomele cu analizele, nu se bazează pe un singur test.
În SEO, triangularea înseamnă câteva lucruri concrete și accesibile:
Bing Webmaster Tools oferă 24 de luni de date de performanță în căutare, complet independent de infrastructura Google. Nu este afectat de bug-urile GSC, nu este influențat de parametrul &num=100, nu a avut o eroare de logging de 50 de săptămâni. Dacă tendința din Bing corelează cu tendința din GSC, ești pe un teren mai solid. Dacă nu corelează, ai o problemă de investigat.
Google Analytics 4 — sesiunile organice — rămâne o sursă curată pentru traficul real. Sesiunile nu pot fi fabricate de boți în același mod în care pot fi fabricate impresiile. O creștere de impresii care nu se traduce în nicio creștere de sesiuni organice este un semnal de alertă, nu un succes de celebrat.
Instrumentele de rank-tracking independente — Sistrix pentru piața europeană, Ahrefs, Semrush — au propriile baze de date de căutare, construite independent de API-urile Google. Tendințele de vizibilitate din aceste instrumente nu ar trebui să divergă dramatic de tendințele din GSC pe perioade lungi. Dacă divergează, ceva e greșit undeva.
Logurile de server, acolo unde există și sunt păstrate, oferă cel mai granular nivel de adevăr despre ceea ce s-a întâmplat real pe site: ce URL-uri a accesat Googlebot, cu ce frecvență, cu ce rezultate. Logurile nu mint. Nu au interfață frumoasă, nu produc grafice automate, dar nu au nici bug-uri de 50 de săptămâni.
Toate acestea sunt disponibile. Majoritatea sunt gratuite sau incluse în instrumente pe care orice agenție serioasă le folosește deja. Ceea ce lipsește nu este accesul la date. Este disciplina de a le folosi sistematic, nu doar atunci când o anomalie devine imposibil de ignorat.
Despre viteza cu care dispare memoria digitală
Există o dimensiune a acestei povești pe care nu am văzut-o discutată suficient: efectul psihologic al dispariției instrumentelor Google asupra memoriei instituționale a industriei.
Când Universal Analytics a dispărut în iulie 2024, au dispărut odată cu el ani de date istorice pentru mii de site-uri care nu și-au exportat datele la timp. Nu vorbim despre date abstracte — vorbim despre comportamentul real al utilizatorilor reali pe o perioadă de 5, 7, 10 ani. Date pe care nu le vei mai putea recupera niciodată, indiferent ce ai fi dispus să plătești.
Când Google Cache a dispărut în septembrie 2024, a dispărut cu el capacitatea de a vedea cum indexase Google o pagină web la un moment dat în trecut. Pentru cercetători, jurnaliști, analiști de conținut, pentru oricine dorea să documenteze o schimbare în timp — o fereastră s-a închis definitiv.
Când Google Optimize a dispărut în septembrie 2023, au dispărut cu el rezultatele a mii de experimente A/B conduse de echipe de marketing care nu și-au exportat datele. Ani de learninguri despre comportamentul utilizatorilor, evaporate.
Există un proverb care spune că „nu știi ce ai până nu pierzi". În contextul platformelor Google, versiunea mai precisă este: nu știi că ai putea pierde până când e deja prea târziu să exporți. Modelul repetat al Google este anunțul cu avertizare minimă, termenul scurt, ștergerea fără apel.
Iar noi, în industrie, am normalizat acest comportament. L-am acceptat ca pe o condiție naturală a lucrului cu platforme tech mari. Am uitat că normalul nu înseamnă corect.
Ce ar trebui să se schimbe — și de ce probabil nu se va schimba
Să fim sinceri până la capăt.
Google nu va schimba acest model în urma unui articol, sau a zece articole, sau a o mie de plângeri în forumuri SEO. Modelul există pentru că servește interesele companiei: instrumentele vechi sunt costisitoare de menținut, datele vechi sunt costisitoare de stocat, comunicarea detaliată despre probleme interne ar genera vulnerabilitate juridică și de reputație. „De ce să anunți că datele tale au fost greșite un an dacă poți pune o notă de două rânduri pe o pagină pe care nimeni nu o citește?"
Aceasta este logica unui actor instituțional mare. Nu e morală, dar e previzibilă.
Ceea ce se poate schimba este comportamentul nostru. Al agențiilor. Al consultanților. Al celor care livrează rapoarte și strategii bazate pe date digitale.
Prima schimbare este de ordin epistemic: să renunțăm la tratarea oricărei surse de date — inclusiv Google — ca pe un oracol infailibil. Datele sunt estimări. Platformele sunt sisteme care pot eșua. Oficialul nu înseamnă corect.
A doua schimbare este de ordin metodologic: introducerea sistematică a triangulării în orice proces de raportare. Nu ca o opțiune pentru clienții premium, ci ca o practică de bază, ca minimul deontologic al meseriei.
A treia schimbare este de ordin contractual: documentarea clară, în relația cu clientul, a limitelor instrumentelor folosite. „Raportul de față se bazează pe date Google Search Console, care prezintă limitările cunoscute documentate în [link]. Recomandăm triangularea cu sursele X, Y, Z." O frază. Câteva secunde. O diferență enormă în caz de eroare.
A patra schimbare este de ordin arhival: exportul regulat al datelor din orice platformă Google, nu ca reacție la un anunț de retragere, ci ca practică preventivă permanentă. Dacă datele din Universal Analytics ale unui client sunt importante, ele ar fi trebuit exportate și stocate în fiecare trimestru — nu în panica din luna care a precedat shutdown-ul.
Întoarcerea la primul principiu
Tatăl meu — mecanic, nu informatician — avea o regulă pe care o aplica înainte de orice intervenție la un motor: „Nu te baza pe ce îți spune aparatul. Pune mâna și simte." Nu pentru că aparatele de diagnosticare ar fi fost proaste. Ci pentru că știa că niciun aparat nu este infailibil și că mâna lui, coroborată cu aparatul, era mai de încredere decât aparatul singur.
Este un principiu vechi cât mecanica: instrumentele sunt ajutoare, nu substitute pentru judecată.
Noi am uitat asta. Am lăsat graficele din Google Search Console să gândească în locul nostru. Am livrat rapoarte ca și cum numerele din platformă ar fi realitate directă, nu reprezentare mediată — și parțial distorsionată — a realității. Am confundat comoditatea cu rigoarea.
Bug-ul de 50 de săptămâni nu este o catastrofă din care industria nu-și va mai reveni. Este o lecție pe care industria o merită, dacă are înțelepciunea să o asculte.
Lecția nu este că Google e rău sau că Search Console e inutil. Lecția este că orice instrument, oricât de oficial, oricât de mare compania din spatele lui, poate greși — și greșeala lui devine greșeala ta dacă o distribui clienților fără să o fi verificat.
Cine verifică, nu greșește de două ori. Cine nu verifică, riscă să nu știe niciodată câte ori a greșit.
Epilog: datele care nu au existat niciodată
Pe undeva, în serverele Google, există o bază de date în care sunt înregistrate impresiile false — cele generate de boți prin &num=100, cele umflate de bug-ul de logging din 2025. Nu le vom vedea niciodată. Nu vom ști niciodată exact cu cât au deviat de la realitate.
Și asta este, poate, cea mai sinistră parte a poveștii: nu că datele au fost greșite, ci că nu vom putea niciodată să cuantificăm exact cât de greșite au fost. Rapoartele livrate în acei ani rămân în dosare. Deciziile luate pe baza lor rămân luate. Efectele lor sunt în lume — în bugete alocate sau retrase, în strategii de conținut adoptate sau abandonate, în evaluări de performanță care au determinat angajări sau concedieri.
Datele false nu dispar odată cu corectarea bug-ului. Ele persistă în consecințele lor.
Acesta este motivul pentru care rigoarea metodologică nu este un moft academic. Este respectul față de oamenii care iau decizii reale pe baza muncii noastre.
Surse și referințe
Deprecări instrumente Google — documentație
- Gary Illyes / Google Search Central — declarații privind Crawl Rate Limiter Tool deprecation (nov. 2023 – ian. 2024)
- Search Engine Land — Googlebot crawl rate tool in Search Console is going away (nov. 2023)
- Search Engine Journal — Google Removing Crawl Rate Limiter Tool From Search Console (nov. 2023)
Colapsul parametrului &num=100 — sept. 2025
- Smith Digital — Why Google Search Console Impressions Dropped in Sept 2025 (dec. 2025)
- Rankfuse — Why Google Search Console Impressions Dropped in September 2025 (dec. 2025)
- Wenstein Beyond Digital — Your Google Search Console Data Just Changed Forever (oct. 2025)
- Search Engine Land — Why Google Search Console impressions fell (and why that's good) (oct. 2025)
- Garrett Digital — Why Google Search Console Impressions Dropped: September 2025 (sept. 2025)
Bug-ul de 50 de săptămâni
- Claudio Novaglio — Google Search Console bug 50 weeks (mai 2026)
- Brodie Clark — analiză LinkedIn (30 martie 2026)
- Google Data Anomalies Page — confirmare oficială (3 aprilie 2026)
Deprecări extinse — ecosistem Google
- Bounteous — So Long, Universal Analytics: GA4 Replaces Universal Analytics (iulie 2023)
- MarTech — Google is turning off all Universal Analytics services and APIs (aprilie 2024)
- Search Engine Land — Google Optimize will sunset this year (ian. 2023)
- Optimizely — Google Optimize has sunset, what should you do now? (2023)
- Convert.com — Google is Back? Google Making Personalization Moves (dec. 2025)
- TechHelp.ca — Google Removed Cache: What SEOs Need to Know (2024–2026)
- Search Engine Journal — Google Removes Cache Search Operator Documentation (oct. 2024)
- SEO TL;DR Substack — Google Removing the Disavow Tool (mai 2024)
- SE Roundtable — Google Search Console API Data Stuck Since June 3rd (iun. 2025)
Întrebările
Douăzeci de întrebări despre modelul Google de deprecare — cu răspunsuri
1. Google Search Console este cu adevărat nesigur, sau articolul exagerează situația?
Niciuna dintre variante în totalitate. Articolul nu susține că Search Console este inutil — susține că a fost tratat ca infailibil atunci când dovezile nu justifică această încredere. Clickurile, acoperirea indexului, inspecția URL și datele de crawling rămân fiabile. Ceea ce a fost demonstrabil compromis sunt impresiile și metricele derivate din ele — CTR și poziția medie — pe perioade specifice, documentate. Argumentul este pentru scepticism calibrat, nu pentru respingere totală. Distincția contează enorm în practică.
2. De ce nu a detectat Google însuși bug-ul de logging de 50 de săptămâni?
Întrebarea nu a primit un răspuns public, iar Google nu a oferit nicio explicație dincolo de nota minimală de confirmare. Cele mai plauzibile explicații tehnice implică faptul că bug-ul a afectat un strat de logging care nu era supus unor verificări automate de consistență — ceea ce înseamnă că datele procesate vizibile în interfață au divergut silențios de datele brute subiacente, fără a declanșa nicio alertă internă. Dacă această situație reflectă un deficit de infrastructură de monitorizare, o reducere de personal în echipa relevantă, sau ceva mai sistemic, nu este cunoscut public. Tăcerea în jurul cauzei este ea însăși un semnal informativ.
3. Deprecarea parametrului &num=100 înseamnă că toate datele istorice de impresii sunt inutilizabile?
Nu toate, și nu în egală măsură. Contaminarea a fost mai puternică în impresiile desktop, în special pentru site-uri care se clasau pe pozițiile 11–100 — intervalul cel mai frecvent recoltat de boții de rank-tracking care foloseau parametrul. Site-urile cu clasamente solide pe pozițiile 1–10 au fost mai puțin afectate, deoarece acele poziții apar pe pagina standard cu zece rezultate și ar fi fost contorizate indiferent. Totuși, orice comparație an-la-an care traversează pragul septembrie 2025 fără a ține cont de discontinuitate este structural viciată. Datele dinainte și după acea dată nu sunt direct comparabile.
4. Ce este Bing Webmaster Tools și este suficient de independent pentru a servi ca sursă de triangulare?
Bing Webmaster Tools este echivalentul Microsoft al Google Search Console — o platformă gratuită care oferă date de performanță în căutare (impresii, clickuri, poziție medie, informații de crawlare) pentru site-urile care apar în Bing. Este independent de infrastructura Google în orice sens relevant: crawlere diferite, sisteme de logging diferite, fluxuri de date diferite. Limitarea sa principală ca sursă de triangulare este cota de piață — Bing reprezintă aproximativ 3–5% din traficul global de căutare, ceea ce înseamnă că numerele absolute sunt mai mici și semnificația statistică a tendințelor pentru cuvinte-cheie individuale este mai scăzută. Totuși, pentru triangulare direcțională — confirmarea că o tendință largă este reală și nu un artefact al unei anomalii GSC — este perfect utilizabil, iar cele 24 de luni de istoric de date îl fac deosebit de valoros pentru comparații pe termen lung.
5. Parametrul &num=100 ar fi putut fi deprecat din motive legitime, fără legătură cu calitatea datelor?
Absolut, și probabil a fost. Cele mai credibile explicații sunt: costul infrastructurii (servirea a 100 de rezultate pe interogare consumă de aproximativ zece ori mai multe resurse de server decât servirea a 10, la miliarde de interogări zilnice); protejarea datelor de căutare față de scraperele de antrenament AI (companiile care construiesc modele lingvistice de mari dimensiuni recoltau date SERP la scară prin această rută); și îmbunătățirea igienei datelor ca efect secundar al eliminării traficului non-uman din fluxul de măsurare. Faptul că deprecierea a avut efecte benefice asupra calității datelor nu înseamnă că a fost motivată de calitatea datelor. Aceste explicații nu se exclud reciproc, iar Google nu și-a dezvăluit rațiunea principală.
6. Cum ar trebui o agenție să comunice anomalia de date de 50 de săptămâni clienților existenți?
Direct și proactiv, fără să aștepte să fie întrebată. O notă scrisă scurtă care explică că Google a confirmat o eroare de logging ce a afectat datele de impresii între 13 mai 2025 și 27 aprilie 2026, care clarifică ce rapoarte sunt afectate, și care propune o linie de bază revizuită construită din clickuri și sesiuni organice în GA4 — aceasta este acțiunea minimă responsabilă. Tentativa de a reformula rapoartele în tăcere, fără dezvăluire, este în cel mai bun caz înșelătoare. În cel mai rău caz, constituie o încălcare a obligației profesionale față de clienți care au luat decizii pe baza acelor cifre. Disconfortul conversației nu este o justificare validă pentru a o evita.
7. Problema „Google Graveyard" este unică pentru Google, sau platformele mari se comportă similar?
Alte platforme mari prezintă tipare similare, dar cazul Google este distinctiv din două motive. În primul rând, instrumentele care sunt deprecate sunt adesea singurul canal oficial prin care publisherii pot înțelege relația lor cu platforma — nu există un echivalent independent al Search Console pentru Google Search. Când Google elimină sau degradează acest canal, nu există un substitut cu autoritate echivalentă. În al doilea rând, dominanța de piață a Google înseamnă că datele sale sunt integrate într-un număr imens de procese de afaceri la nivel global. Deprecierea unei funcții de analytics Facebook este perturbatoare; deprecierea singurului instrument de transparență pentru cel mai mare motor de căutare din lume este diferită structural în esența ei.
8. Ce este exact „efectul de aligator" și este un termen tehnic recunoscut?
Este un termen descriptiv apărut din analiza comunității în toamna lui 2025, nu un concept tehnic recunoscut formal. Se referă la tiparul vizual de pe graficele de performanță GSC — vizibil din aproximativ februarie 2025 încoace — în care impresiile urcau constant în timp ce clickurile rămâneau plate, creând o divergență expansivă care semăna cu fălcile deschise ale unui aligator privit din profil. Tiparul a fost identificat retrospectiv ca semnal al inflației de impresii cauzate de activitatea boților prin &num=100. Nu este un termen definit de Google, nu are statut oficial și trebuie înțeles ca o prescurtare utilă a comunității, nu ca taxonomie tehnică.
9. Dacă Google a remediat bug-ul, rapoartele din mai 2026 încoace sunt din nou fiabile?
Cu rezerve, da — pentru impresii. Google a confirmat că bug-ul a fost rezolvat la 27 aprilie 2026, iar datele colectate după această dată ar trebui să reflecte un logging corect. Totuși, „fiabil" necesită o precizare: eliminarea inflației de la &num=100 a fost un eveniment separat (septembrie 2025), deja incorporat în fluxul de date înainte ca bug-ul de logging să fie confirmat. Deci impresiile post-aprilie 2026 sunt atât libere de eroarea de logging, cât și deja ajustate la linia de bază post-&num=100. Compararea lor cu orice cifre anterioare lunii septembrie 2025 fără ajustare explicită rămâne problematică.
10. De ce a fost nevoie de un consultant independent din Australia pentru a găsi o eroare de date de un an într-una dintre cele mai folosite platforme web din lume?
Aceasta este, poate, întrebarea cea mai importantă pe care o ridică articolul, iar răspunsul sincer este că nu știm. Posibilitățile variază de la benigna (anomalia era suficient de subtilă încât să fie invizibilă fără analiza atentă la nivel de segment pe care Brodie Clark a realizat-o) la îngrijorătoarea (monitorizarea internă exista, dar nu s-a acționat prompt). Ceea ce se poate afirma cu certitudine este că secvența de tip „comunitate înainte de companie" nu este fără precedent în istoria Google — anomalia &num=100 a fost de asemenea identificată extern înainte de orice recunoaștere oficială. Dacă acest lucru reflectă o sub-investiție structurală în monitorizarea calității datelor, o cultură a divulgării întârziate, sau pur și simplu realitatea că o bază de utilizatori vastă oferă o acoperire mai bună decât orice echipă internă — este o întrebare care merită pusă mai tare decât este în prezent.
11. Această analiză se aplică în egală măsură Google Analytics 4, sau GSC este un caz special?
GA4 are propriile limitări și controverse documentate — modelul său de date diferă substanțial de Universal Analytics, definițiile sesiunilor s-au schimbat, iar migrarea a distrus comparabilitatea istorică pentru multe afaceri. Totuși, datele de bază din GA4 privind evenimentele și sesiunile nu au fost supuse aceluiași tip de inflație sistematică ca impresiile GSC. Măsurarea fundamentală a dacă un utilizator a vizitat site-ul tău și ce a făcut acolo este mai robustă decât măsurarea dacă un rezultat de căutare a fost afișat. GSC se află la un punct mai fragil în lanțul de date: depinde de logul intern al Google privind propriile afișări ale rezultatelor de căutare, care sunt mai puțin direct observabile decât vizitele pe site și, prin urmare, mai greu de verificat prin mijloace independente.
12. Cum arată triangularea în practică într-un raport SEO lunar?
Într-un raport lunar bine structurat, triangularea ar putea lua următoarea formă: clickurile GSC (sursa primară pentru volumul traficului condus de căutare) sunt coroborate cu sesiunile organice GA4 (confirmând că tendințele la nivel de click se reflectă în vizite reale pe site); tendințele de poziție medie din GSC sunt coroborate cu un instrument de rank-tracking pentru cuvintele-cheie principale ale site-ului (confirmând că mișcările de poziție sunt reale și nu artefacte ale modificărilor de ponderare a impresiilor); iar orice mișcare semnificativă de impresii este verificată față de Bing Webmaster Tools pentru confirmare direcțională. Dacă toate cele trei surse indică aceeași direcție, încrederea în tendința raportată este ridicată. Dacă divergează, divergența în sine devine subiectul de investigat — nu de ignorat.
13. Deprecierea instrumentelor mai vechi este întotdeauna negativă, sau există cazuri în care eliminarea îmbunătățește ecosistemul?
Eliminarea poate îmbunătăți genuinul ecosistem atunci când instrumentul retras îi induce în eroare pe utilizatori, consumă resurse care ar putea îmbunătăți alte produse, sau maschează alternative mai bune. Crawl Rate Limiter este, poate, un caz în care eliminarea a fost decizia corectă — latența instrumentului manual îl făcea mai rău decât inutil în multe scenarii, iar utilizatorii care se bazau pe el ar fi putut opera sub o falsă senzație de control. Problema nu este deprecierea ca atare, ci combinația de: avertizare insuficientă, documentare inadecvată a ce înlocuiește funcționalitatea, și (în cazul platformelor de date) nicio prevedere pentru portabilitatea datelor istorice. Deprecierea fără planificare de tranziție este locul unde tiparul devine cu adevărat dăunător.
14. Cum se raportează această situație la întrebarea mai largă a AI Overviews care reduc ratele de click organic?
Se suprapun într-un mod nefericit. AI Overviews — rezumatele generative ale căutărilor Google — reduc clickurile răspunzând la interogări direct în pagina de rezultate, ceea ce înseamnă că utilizatorii primesc informații fără a vizita site-ul sursă. Aceasta produce o reducere reală și structurală a CTR-ului organic. Totuși, dacă încearcă să măsoare această reducere folosind date CTR din GSC din perioada afectată (mai 2025 – aprilie 2026), numitorul (impresiile) era artificial umflat, ceea ce înseamnă că CTR-ul calculat era artificial deflat — făcând efectul AI Overviews să pară mai mare decât era în realitate. Analiștii care au încercat să cuantifice impactul AI Overviews folosind date GSC din această perioadă este posibil să fi supraestimat semnificativ acel impact.
15. Ce se întâmplă cu site-urile care au folosit extensiv Disavow Tool și acum se confruntă cu potențiala sa eliminare?
Dacă Disavow Tool este retras în cele din urmă, impactul practic va fi probabil modest pentru majoritatea site-urilor. Rațiunea lui John Mueller — că algoritmii Google au devenit suficient de capabili să ignore link-urile manipulative fără instrucțiuni manuale — este în linii mari credibilă. Pentru site-urile sub acțiuni manuale active legate de spam de link-uri, instrumentul rămâne cel adecvat până la retragerea sa formală. Preocuparea mai imediată pentru utilizatorii intensivi ai instrumentului este dacă un fișier de disavow istoric va continua să fie respectat după eliminarea toolului — ceva la care Google nu a răspuns public încă. Această ambiguitate este ea însăși un produs al tiparului descris în articolul principal: anunțarea eliminării fără un cadru complet de tranziție.
16. Există argumente că problemele de date Google se agravează în timp, sau au existat întotdeauna anomalii pe care pur și simplu nu le observam?
Ambele sunt probabil adevărate simultan. Au existat întotdeauna anomalii în datele GSC — platforma nu a pretins niciodată că oferă date exacte mai degrabă decât eșantionate, iar limita de păstrare a datelor de 16 luni a restricționat întotdeauna analiza longitudinală. Ceea ce s-ar putea schimba este amploarea anomaliilor în raport cu încrederea acordată datelor. Pe măsură ce tot mai multe decizii de afaceri — inclusiv strategii de conținut conduse de AI, alocări de bugete și evaluări de performanță — sunt luate pe baza cifrelor din GSC, costul erorilor silențioase crește. Problema de credibilitate a platformei este parțial intrinsecă și parțial o funcție a greutății pe care industria a ales să o plaseze pe ea.
17. Poate fi greșit chiar acest articol — de exemplu, dacă bug-ul de 50 de săptămâni se dovedește a fi mai puțin semnificativ decât descris?
Da, și această posibilitate trebuie recunoscută deschis. Analiza semnificației bug-ului se bazează pe raportări ale unor terțe părți — în principal analiza lui Claudio Novaglio și răspunsul comunității la postarea LinkedIn a lui Brodie Clark — nu pe acces direct la datele interne ale Google. Confirmarea proprie a Google a constat în două rânduri. Dacă supranumărarea a fost, de exemplu, concentrată într-un număr mic de tipuri de căutare sau zone geografice și nu distribuită la fel de larg cum a fost raportat, impactul practic ar fi mai îngust decât cel descris aici. Articolul procedează pe baza celei mai riguroase analize externe disponibile la mai 2026. Nu revendică certitudini pe care nu le posedă.
18. Cum ar arăta o guvernanță responsabilă a platformei din partea Google?
Mai multe lucruri, niciunul dificil tehnic. Notificări automate ale utilizatorilor când este detectată o anomalie de date, comparabile cu modul în care Google notifică proprietarii de site-uri despre problemele de indexare. O perioadă minimă de notificare de șase luni pentru orice deprecare de instrument, cu o cale de migrare clar documentată înainte de anunțarea deprecierii. Ferestre garantate de portabilitate a datelor — cel puțin douăsprezece luni în care datele istorice pot fi exportate în formate procesabile automat. Documentație publică transparentă a limitărilor cunoscute de calitate a datelor, menținută în timp real, nu retroactiv. Și, specific pentru anomaliile de date: un angajament față de corecție retroactivă sau, acolo unde corecția nu este fezabilă, o declarație clară despre care metrici sunt afectate și cu ce amploare aproximativă. Nimic din toate acestea nu este radical. Este ceea ce orice furnizor de date reglementat ar fi obligat să ofere.
19. Ar trebui profesioniștii SEO să fie mai critic publici față de calitatea datelor Google, sau asta dăunează inutilității încrederii clienților?
Onestitatea profesională și încrederea clienților nu sunt atât de opuse pe cât ar părea. Clienții care primesc evaluări oneste ale limitărilor de date sunt mai bine echipați să ia decizii solide; clienții care primesc rapoarte artificialmente sigure bazate pe date nesigure sunt expuși riscului de decizii fondate pe ficțiune. Disconfortul pe termen scurt de a spune „aceste date au limitări cunoscute și iată cum le gestionăm" este depășit de încrederea pe termen lung construită prin metodologie transparentă. Reticența industriei de a critica public calitatea datelor Google este înțeleasă — Google controlează traficul de care depind multe agenții — dar este, în final, o formă de lașitate instituțională mascată drept serviciu pentru client.
20. Care este cea mai importantă schimbare practică pe care un consultant SEO solo sau o agenție mică ar putea-o implementa mâine?
Exportați lunar datele de sesiuni organice din GA4 și datele de clickuri din GSC ale clienților voștri și stocați-le în propriul sistem — un spreadsheet, o bază de date, oriunde dețineți controlul. Faceți asta indiferent de cât de fiabile par platformele în prezent. Lecția din Universal Analytics nu este că Google vă va avertiza întotdeauna în timp util. Lecția este că s-ar putea să nu o facă, și că datele pe care nu le dețineți voi înșivă sunt date pe care le puteți pierde fără niciun recurs. Asta ia poate treizeci de minute per client pe lună. Este actul minim de responsabilitate profesională într-un ecosistem în care regulile de păstrare a datelor sunt scrise de un singur actor și pot fi modificate fără negocieri semnificative.
Nota autorului
Ce poate și ce nu poate revendica acest text — și de ce contează. Limite, tensiuni și unelte.
Despre surse
Fiecare afirmație factuală din articolul principal și din aceste întrebări se bazează pe raportări publicate ale unor surse identificabile — Search Engine Land, Search Engine Journal, analiza independentă a lui Claudio Novaglio, documentația LinkedIn a lui Brodie Clark, propria pagină de anomalii de date a Google și raportările comunității prin SE Roundtable și forumuri comparabile. Aceste surse sunt denumite și referențiate în secțiunea de bibliografie.
Ceea ce textul nu are acces la sunt datele interne ale Google. Bug-ul de 50 de săptămâni este descris și implicațiile sale sunt analizate, dar amploarea precisă a supranumărării — câte impresii, pentru ce site-uri, distribuite cum pe geografie și tipuri de căutare — este necunoscută. Confirmarea publică a Google a constat în două rânduri. Analiza se bazează, prin urmare, pe cea mai riguroasă reconstrucție externă disponibilă, nu pe cifre interne verificate. Acolo unde amploarea este incertă, am încercat să spun explicit.
Despre cadrul interpretativ
Articolul este scris dintr-o perspectivă critică. Argumentează că există un tipar și că tiparul are costuri. Acest cadru implică o alegere: aș fi putut scrie un text la fel de exact subliniind că Google furnizează Search Console gratuit, că platforma oferă valoare genuină, și că industria nu are niciun drept la date fără erori dintr-un instrument terț pentru care nu plătește. Acel cadru ar fi fost de asemenea apărabil.
Am ales cadrul critic pentru că cred că postura implicită a industriei — tratarea datelor Google ca autoritative fără verificare sistematică — este mai periculoasă decât orice critică a platformei, și că dovezile disponibile susțin o contestare a acelei posturi. Cititorii care găsesc cadrul prea adversarial reflectă, cred, un punct de vedere alternativ rezonabil, nu unul incorect.
Despre uneltele folosite în scrierea acestui text
Atât articolul principal, cât și aceste întrebări au fost dezvoltate în colaborare cu Claude Sonnet 4.6 (Anthropic), pornind de la un brief de cercetare și o fundație bibliografică pe care le-am compilat independent. Cercetarea — identificarea surselor, verificarea datelor, confirmarea afirmațiilor factuale — a fost realizată de mine prin căutare web în sursele citate. Procesul de scriere a implicat iterație între direcția mea editorială și redactarea modelului, cu deciziile finale despre cadru, ton și includere rămânând la mine.
Documentez acest lucru nu ca o disclamer, ci ca o chestiune de transparență pe care o consider obligatorie profesional, dat fiind că acest site a scris extensiv despre limitele epistemice ale AI. A folosi un instrument ascunzând utilizarea lui ar fi o formă de inconsecvență pe care nu sunt dispus să o practic.
Modelul a fost util pentru: menținerea coerenței structurale pe parcursul unui text lung, asigurarea consecvenței gramaticale și stilistice în engleză britanică, și redactarea perechilor de întrebări și răspunsuri dintr-un set de teme pe care le-am identificat eu. Nu a fost util pentru: cercetare originală, verificarea surselor, sau judecățile editoriale despre ce să includ, să accentuez sau să calific. Acestea au rămas ale mele.
Despre tensiuni
Există o tensiune în acest articol pe care vreau să o numesc mai degrabă decât să o netezesc.
Textul critică Google pentru că a comunicat eșecurile de date cu transparență minimă. Argumentează apoi că profesioniștii ar trebui să comunice clar limitările de date clienților lor. Aceasta nu este contradictorie — actori diferiți au responsabilități diferite — dar tensiunea există deoarece profesioniștii care ar trebui să aibă aceste conversații oneste depind adesea, comercial, de bunăvoința traficului direcționat de Google. A critica platforma care controlează vizibilitatea clienților tăi nu este lipsit de costuri. Am încercat să argumentez pentru ceea ce este corect mai degrabă decât pentru ceea ce este confortabil, dar recunosc că argumentul este mai ușor de făcut dintr-o poziție de independență editorială relativă decât din interiorul unei agenții ai cărei clienți principali se clasează pe Google.
O a doua tensiune: articolul cere triangularea datelor ca practică standard, recunoscând totodată că sursele alternative — Bing Webmaster Tools, GA4, loguri de server, rank-trackere independente — au fiecare propriile limitări. Triangularea nu produce certitudine; produce incertitudine mai bine calibrată. Îmbunătățirea este reală și merită urmărită, dar nu vreau să sugerez că răspunsul la o sursă imperfectă este o colecție de surse perfect fiabile. Nu este. Răspunsul este o relație mai onestă cu imprecizia fundamentală a măsurătorii digitale.
Despre ce lipsește
Acest text nu abordează: dimensiunile juridice și de reglementare ale unei platforme majore care furnizează date incorecte afacerilor care se bazează pe ele comercial — o întrebare care ar putea atrage atenția autorităților de concurență, în special în Europa. Nu examinează în detaliu cum rezumatele generate de AI au probabilitatea de a schimba relevanța măsurătorii bazate pe impresii în următorii doi-trei ani, dincolo de mențiunea scurtă din întrebarea 14. Și nu oferă o evaluare cuprinzătoare a GA4 ca platformă de date, care are propriile probleme semnificative documentate ce merită un tratament separat.
Acestea nu sunt omisiuni din ignoranță. Sunt decizii de scop. Un eseu de 4.000 de cuvinte nu poate face totul.
Un cuvânt final despre certitudine
Cea mai puternică afirmație din acest articol este și cea mai verificabilă: Google a confirmat o eroare de logging ce a afectat datele de impresii din Search Console timp de cincizeci de săptămâni consecutive, iar confirmarea a venit la patru zile după ce un consultant independent a identificat public anomalia. Orice altceva — interpretarea a ceea ce înseamnă asta, argumentul despre responsabilitate profesională, apelul la schimbare metodologică — este analiză construită pe acea fundație.
Analiza poate fi contestată. Fundația, la Mai 2026, nu poate.
„Google nu este singur"
Bibliografie: Big Tech și modelul deprecierii unilaterale a instrumentelor proprii
1. Meta / Facebook — deprecări în cascadă, 2024–2025
Cel mai apropiat paralel structural cu comportamentul Google, operând la scară comparabilă și cu o opacitate comparabilă față de utilizatori și dezvoltatori.
Programul continuu de deprecare a API-urilor
Meta a implementat un program continuu de deprecare a API-urilor pe parcursul anilor 2024 și 2025. În august 2025, a deprecat metrici suplimentare din Page Insights API, inclusiv măsurătorile de „impressions" și „page fans", cu un preaviz de 90 de zile. În octombrie 2024, a eliminat peste 100 de metrici unice din Ads Insights API, afectând câmpurile unique_actions și cost_per_unique_action_type folosite de mii de platforme de marketing technology. Lansarea Graph API v21.0 din octombrie 2024 a anunțat simultan deprecierea Messaging Events API, programată pentru septembrie 2025, împingând dezvoltatorii spre Conversion API ca soluție preferată de Meta.
Surse:
-
PPC Land — Meta deprecates additional Page Insights API metrics from November 15 (aug. 2025)
-
Sprout Social Support — Facebook Metric Deprecation — November 2025 (nov. 2025)
-
PPC Land — Meta discontinues Facebook Like and Comment buttons for external websites (nov. 2025)
Facebook Groups API — 90 de zile preaviz, niciun înlocuitor real
În ianuarie 2024, Meta a anunțat deprecierea Facebook Groups API — folosit de dezvoltatori și companii pentru a programa postări în grupuri Facebook — cu un preaviz de 90 de zile. Eliminarea a inclus toate permisiunile și funcționalitățile asociate API-ului. Instrumente terțe de social media management, inclusiv Zoho Social, au fost nevoite să întrerupă complet suportul pentru Facebook Groups, afectând utilizatorii care aveau conținut programat pentru publicare după data deprecierii. Postările programate exclusiv pentru Facebook Groups au fost automat mutate în Drafts fără nicio posibilitate de publicare.
Surse:
-
TechCrunch — Meta cuts off third-party access to Facebook Groups, leaving developers and customers in disarray (feb. 2024)
-
Zoho Help Community — Discontinuing Facebook Groups due to API deprecation (apr. 2024)
Butoanele Like și Comment pentru site-uri externe — retrase noiembrie 2025
Pe 10 noiembrie 2025, Meta a anunțat retragerea a două plugin-uri sociale — butonul Facebook Like și butonul Facebook Comment pentru site-uri externe — ca parte a unei strategii mai largi de „simplificare a platformei". Anunțul i-a îndrumat pe dezvoltatori spre un canal de suport și un FAQ, deși suportul tehnic pentru funcțiile deprecate se reduce sistematic pe măsură ce datele de încheiere se apropie. Analiza comunității de dezvoltatori a concluzionat că deprecările Meta ar trebui tratate ca un tipar continuu, nu ca incidente izolate.
Sursă: PPC Land — Meta discontinues Facebook Like and Comment buttons for external websites (nov. 2025)
2. Twitter / X — distrugerea unui ecosistem de dezvoltatori în 48 de ore
Cel mai extrem caz documentat de deprecare unilaterală fără avertizare semnificativă — și cea mai instructivă comparație pentru tiparul Google, tocmai prin contrast: unde Google tace, Twitter/X a distrus în public.
Eliminarea accesului gratuit la API — februarie 2023
Pe 2 februarie 2023, Twitter a anunțat că accesul gratuit la API va înceta pe 9 februarie — șapte zile preaviz. Decizia a spart sau a limitat sever zeci de instrumente terțe, inclusiv platforme de analytics, schedulere de tweet-uri, instrumente de arhivare și unelte de cercetare academică. Dezvoltatorii dispuși să plătească pentru nivelul enterprise au raportat că nu primiseră niciun răspuns de la echipa de vânzări enterprise a Twitter în zilele de după anunț, în timp ce accesul lor la API fusese tăiat fără avertizare. Noua structură de prețuri a stabilit nivelul Pro la 5.000 de dolari pe lună — o barieră prohibitivă pentru dezvoltatorii independenți și cercetătorii academici.
Surse:
-
Engadget — Twitter shut off its free API and it's breaking a lot of apps (apr. 2023)
-
The Register — No more free API access, says Twitter (feb. 2023)
-
TechCrunch — Twitter to end free access to its API (feb. 2023)
-
Social Media Today — Twitter's Cancelling Free Access to its API (feb. 2023)
Clienții terți — eliminați în ianuarie 2023, fără niciun cuvânt oficial
Cu două săptămâni înainte de anunțul API, Twitter a eliminat o serie de clienți terți fără niciun comunicat oficial privind motivul. Aplicații precum Tweetbot, care funcționaseră peste un deceniu, au încetat pur și simplu să funcționeze. Niciun preaviz, nicio explicație, niciun calendar. Gedeon Maheux, cofondatorul Iconfactory, a descris situația drept distrugerea muncii a mii de dezvoltatori externi care construiseră instrumente utile, jocuri și sisteme de analytics pe platformă.
Sursă: The Register — No more free API access, says Twitter (feb. 2023)
Restricții continue — 2024–2025
X a continuat să înăsprească restricțiile API pe parcursul anilor 2024 și 2025. În august 2025, a eliminat posibilitatea de a da like postărilor și de a urmări conturi prin nivelul gratuit al API-ului. Schimbările au impactat ecosistemul de dezvoltatori atât de sever încât instrumente precum Block Party al lui Tracy Chou au pivotat complet spre alte platforme. Regulatorii UE au parțial inversat restricțiile de acces pentru cercetători, invocând obligațiile din Digital Services Act — un exemplu rar de reglementare externă care a depășit unilateralismul platformei.
Surse:
-
TechCrunch — X pulls the ability to like and follow from its developer API's free tier (aug. 2025)
-
TechCrunch — X launches top-up packs for its developer API (mar. 2024)
-
DeleteOldPosts — Twitter/X API Changes 2024–2026 (2026)
3. Microsoft — 16 funcționalități deprecate într-un singur an
O variantă diferită a aceluiași tipar: deprecare la scară largă condusă de repoziționare strategică mai degrabă decât de monetizare, dar cu consecințe echivalente pentru utilizatorii dependenți.
2023 — anul deprecărilor masive
În 2023 singur, Microsoft a deprecat 16 funcționalități diferite din Windows 11. Cele mai semnificative:
-
Cortana — asistentul virtual Microsoft, activ din 2014 și prezent pe Windows, Xbox, Teams și Outlook mobile, a fost retras ca aplicație standalone în primăvara lui 2023 și din toate integrările Microsoft 365 mobile până în toamna lui 2023. A fost înlocuit de Microsoft Copilot, care a obligat utilizatorii să reia de la zero configurarea și integrarea unui alt asistent cu o arhitectură diferită.
-
WordPad — prezent în Windows din 1995, deprecat în 2023 fără un înlocuitor direct în sistemul de operare. Utilizatorii care se bazau pe el pentru editare ușoară de documente RTF nu au primit niciun instrument echivalent gratuit din partea Microsoft.
-
Windows Mixed Reality — eliminat în 2023 după ce Microsoft s-a retras din construirea nativă de VR/AR în Windows. Dezvoltatorii care construiseră aplicații pe platformă au primit ghidare limitată de tranziție.
-
Azure Kinect DK — kit de dezvoltator derivat din tehnologia Xbox Kinect, retras în 2023 din cauza adoptării scăzute. Proiectele din domeniul sănătății și roboticii construite pe capabilitățile sale de urmărire a mișcării au rămas fără o cale de succesor clară.
-
Aplicațiile Mail și Calendar — plasate în modul de mentenanță în 2023 și retrase în 2024, înlocuite de un nou client Outlook construit pe tehnologii web. Utilizatorii care configuraseră Mail și Calendar de-a lungul anilor au fost obligați să migreze spre o aplicație substanțial diferită.
Surse:
-
Windows Central — Microsoft killed 16 different Windows 11 features in 2023 (dec. 2023)
-
Windows Central — Here are all the Microsoft deprecated products as listed by Microsoft Graveyard (ian. 2024)
-
KilledBy.tech — Microsoft 2022–2025: Another Batch of Goodbyes (nov. 2025)
-
Microsoft Support — End of support for Cortana (2023)
-
Neowin — Every Windows feature Microsoft removed or deprecated in 2025 (ian. 2026)
Microsoft Graveyard — documentare comunitară
Volumul deprecărilor Microsoft a determinat un dezvoltator independent să construiască „Microsoft Graveyard" — un site open-source care cataloghează toate produsele Microsoft deprecate și datele lor de încheiere a suportului. Proiectul a fost explicit inspirat de proiectul „Killed by Google" — el însuși un răspuns comunitar la tiparul de abandonare a produselor Google. Existența unor cimitire paralele construite de comunitate atât pentru Google, cât și pentru Microsoft este ea însăși un semnal: când utilizatorii trebuie să construiască propriile instrumente pentru a urmări istoricul de deprecare al unei platforme, comunicarea oficială este structural inadecvată.
Sursă: Windows Central — Here are all the Microsoft deprecated products as listed by Microsoft Graveyard (ian. 2024)
4. Apple — tiparul mai tăcut
Modelul Apple de deprecare este structural diferit — operează prin cicluri hardware și presiunea upgrade-urilor de OS, mai degrabă decât prin retrageri de API — dar efectul asupra utilizatorilor dependenți este comparabil.
iCloud backup-uri — șterse fără opțiune de recuperare
În decembrie 2024, Apple a încetat suportul pentru iCloud backup-uri pe dispozitivele care rulau iOS 8 sau mai vechi. Backup-urile existente pre-iOS 8 stocate în iCloud au fost șterse simultan, fără niciun mecanism de recuperare. Apple a confirmat schimbarea printr-un e-mail trimis clienților afectați — o abordare ușor mai comunicativă decât notele de două rânduri ale Google, deși rezultatul pentru utilizatorii care au ratat notificarea a fost identic: pierdere permanentă de date.
Sursă: How-To Geek via Yahoo — iCloud Backups Will Stop Working On Old iPhone Models (2024)
Advanced Data Protection — retrasă fără notificare prealabilă, Marea Britanie 2025
În februarie 2025, Apple a retras funcția Advanced Data Protection — criptare end-to-end pentru datele iCloud — în Marea Britanie, în urma unei cereri legale a guvernului britanic pentru acces backdoor. Retragerea a fost efectuată fără nicio notificare prealabilă a utilizatorilor din Marea Britanie, care activaseră funcția tocmai pentru garanțiile sale de confidențialitate. Incidentul a ilustrat o variantă a tiparului de deprecare: funcționalitățile pot dispărea nu prin decizii interne de produs, ci prin conformare regulatorie — utilizatorii suportând consecința indiferent de cauză.
Sursă: Captain Compliance — Apple's Shocking Reversal: Advanced Data Protection Pulled (feb. 2025)
Ciclul de upgrade hardware Apple ca deprecare soft
Apple încheie în mod sistematic suportul software pentru dispozitivele mai vechi de șapte ani, eliminând actualizările de OS și patch-urile de securitate. Deși acest lucru este documentat public și înțeles în linii mari, efectul este funcțional echivalent cu deprecierea: hardware-ul achiziționat și folosit devine o vulnerabilitate, iar dezvoltatorii de aplicații încetează suportul pentru versiunile vechi de OS pe propriile lor calendare, adesea mai rapid decât datele oficiale de încheiere a suportului Apple.
Sursă: MacObserver — Apple Devices Losing Support in 2025 (ian. 2025)
5. Cadrul teoretic — enshittification
Contextul intelectual care unifică toate aceste cazuri sub un singur model explicativ. Fără această ancoră, articolul riscă să pară o colecție de plângeri; cu ea, devine o analiză structurală.
Cory Doctorow — formularea canonică
Scriitorul și activistul canadian Cory Doctorow a inventat termenul „enshittification" în noiembrie 2022 pentru a descrie tiparul previzibil de degradare a platformelor digitale. Mecanismul identificat de el are trei stadii: platformele sunt mai întâi bune față de utilizatori, pentru a-i atrage; apoi degradează experiența utilizatorilor pentru a servi clienții business; în final, degradează experiența atât pentru utilizatori, cât și pentru clienții business, pentru a extrage profit maxim pe termen scurt pentru acționari.
American Dialect Society a selectat „enshittification" drept Cuvântul Anului 2023. Macquarie Dictionary din Australia a urmat pentru 2024. Atât Merriam-Webster, cât și Dictionary.com listează acum termenul ca intrare legitimă. În octombrie 2025, Doctorow a publicat o carte exhaustivă pe subiect: Enshittification: Why Everything Suddenly Got Worse and What To Do About It (Farrar Straus & Giroux).
Surse:
-
Wikipedia — Enshittification (în curs de actualizare)
-
The New Stack — Cory Doctorow Reveals How He'd Fix Big Tech's Domination (iul. 2025)
-
Washington Monthly — The Cory Doctorow Doctrine (oct. 2025)
-
Remio.ai — Enshittification: Cory Doctorow on Why the Internet Is Getting Worse (oct. 2025)
-
Arts Fuse — recenzie Enshittification (oct. 2025)
Argumentul structural — de ce preavizul minim nu este accidental
Cadrul lui Doctorow explică de ce avertizarea minimă nu este o neglijență, ci o trăsătură structurală. Platformele nu au niciun stimulent competitiv să-și comunice clar degradările — utilizatorii deja blocați în ecosistem au alternative limitate, iar comunicarea detaliată despre eșecuri generează vulnerabilitate juridică și de reputație. Tiparul nu este neglijență; este comportament rațional în condiții de putere de piață monopolistă. Această înrămare contează pentru argumentul articolului principal: a aștepta ca Google să se comporte mai transparent fără o schimbare structurală a poziției sale de piață înseamnă a aștepta ca un actor rațional să acționeze împotriva propriilor interese.
Surse:
-
Medium — Enshittification: Cory Doctorow on the Collapse of Digital Platforms (dec. 2025)
-
Critical EdTech — The 'enshittification' of the digital (2024)
-
Muhlenberg Magazine — As Platforms Decay, So Do We (ian. 2026)
Tabel comparativ pentru uz editorial
|
Companie |
Deprecarea cea mai semnificativă |
Preaviz acordat |
Date pierdute? |
|---|---|---|---|
|
|
Bug GSC 50 de săptămâni |
Niciunul |
Nu (date corupte, nu șterse) |
|
|
Universal Analytics |
~1 an (modificat de 2 ori) |
Da — ștergere permanentă |
|
|
Google Cache |
Câteva săptămâni |
Nu (Wayback Machine adăugat) |
|
Meta |
Facebook Groups API |
90 de zile |
Nu (funcționalitate eliminată) |
|
Meta |
100+ metrici Ads Insights |
90 de zile |
Nu (metrici eliminate) |
|
Twitter/X |
Acces gratuit la API |
7 zile |
Nu (acces revocat) |
|
Twitter/X |
Clienți terți |
Niciunul |
Nu (ecosistem distrus) |
|
Microsoft |
Cortana (9 ani vechime) |
Câteva luni |
Nu (asistent înlocuit) |
|
Microsoft |
16 funcții Windows 11 |
Variabil |
Nu |
|
Apple |
iCloud backup-uri pre-iOS 8 |
Notificare email |
Da — ștergere permanentă |
|
Apple |
Advanced Data Protection (UK) |
Niciunul |
Nu (criptare eliminată) |
Observație editorială: Cazurile se împart în trei categorii distincte. Prima — eliminarea de instrumente sau funcționalități — este perturbatoare, dar recuperabilă prin alternative. A doua, mai mică, implică ștergerea efectivă a datelor: Universal Analytics (Google) și iCloud backup-uri pre-iOS 8 (Apple). Acestea sunt calitativ mai grave și reprezintă cea mai clară încălcare a contractului implicit dintre platformă și utilizatorii săi. Bug-ul de 50 de săptămâni al Google se află într-o a treia categorie — nici ștergere, nici eliminare, ci corupere silențioasă. În anumite privințe este cel mai insidios dintre cele trei, deoarece este singurul în care utilizatorii nu ar fi avut posibilitatea de a acționa chiar dacă ar fi știut.
Privit prin grila teoretică a lui Yanis Varoufakis din Technofeudalism: What Killed Capitalism (2023, Melville House, 2024), acest tipar nu este o anomalie — este mecanismul constitutiv al noului sistem economic. Varoufakis argumentează că platformele digitale ale Big Tech nu mai funcționează ca actori de piață în sensul capitalist clasic, ci ca seniori feudali digitali: ele controlează infrastructura prin care circulă comerțul, comunicarea și informația și extrag rente din cloud — nu profituri — de la toți cei care trebuie să opereze în interiorul acestor ecosisteme. Utilizatorii, dezvoltatorii independenți și agențiile web care construiesc servicii pe datele Google, Meta sau Apple nu sunt, în această lectură, clienți ai unei piețe libere. Sunt vasali digitali — dependenți de bunăvoința seniorului pentru accesul la uneltele și datele proprii.
Deprecierea unilaterală a instrumentelor, avertizarea minimă și ștergerea datelor fără recurs nu sunt, din această perspectivă, erori de guvernanță corporativă care ar putea fi remediate prin reglementare mai bună sau prin bunăvoință instituțională. Sunt expresii naturale ale unui raport de putere în care seniorul nu are nicio obligație contractuală față de vasal dincolo de cea pe care și-o asumă voluntar. Feudalul nu anunța țăranul cu un an înainte că îi schimbă condițiile de arendă. Platforma nu anunță dezvoltatorul cu mai mult decât minimul legal că îi retrage API-ul pe care și-a construit afacerea.
Această lectură adaugă o dimensiune pe care nici Doctorow, nici analiza tehnică a deprecierii nu o acoperă complet: problema nu este că platformele se comportă rău în mod accidental — problema este că structura de putere în care operează le permite să se comporte astfel în mod sistematic, fără consecințe. A cere mai multă transparență de la Google fără a modifica raportul structural de putere este, în termenii lui Varoufakis, echivalentul de a cere unui senior feudal să fie mai amabil cu iobagii săi — un apel la morală acolo unde problema este de arhitectură economică.
Sursă principală:
- Yanis Varoufakis — Technofeudalism: What Killed Capitalism (Melville House, feb. 2024)
Surse secundare:
- Jacobin — We're Still Living Under Capitalism, Not "Techno-Feudalism" (oct. 2023) — contra-argument util
- The Skeptic — The tyranny of the cloud: how we became serfs to big tech (oct. 2024)
- NPI Cascadia Advocate — Book Review: Yanis Varoufakis' Technofeudalism (mar. 2026)
- Geert Lovink / Network Cultures — Cloud Capital and Platform Regression (mar. 2024)
- Doing Sociology — recenzie Technofeudalism (nov. 2025)
Surse secundare cheie pentru articolul de categorie
-
Cory Doctorow — Enshittification: Why Everything Suddenly Got Worse and What To Do About It (Farrar Straus & Giroux, oct. 2025) — text teoretic fundamental
-
KilledBy.tech — catalog continuu al produselor deprecate de Google, Meta, Microsoft și Apple
-
The Register — acoperire long-form consecventă a deprecărilor de API pe toate platformele
-
TechCrunch — sursa primară pentru schimbările API Twitter/X și impactul asupra ecosistemului de dezvoltatori
-
SE Roundtable (Barry Schwartz) — sursa primară pentru deprecările de instrumente specifice Google