


Unealta bună nu face nimic singură.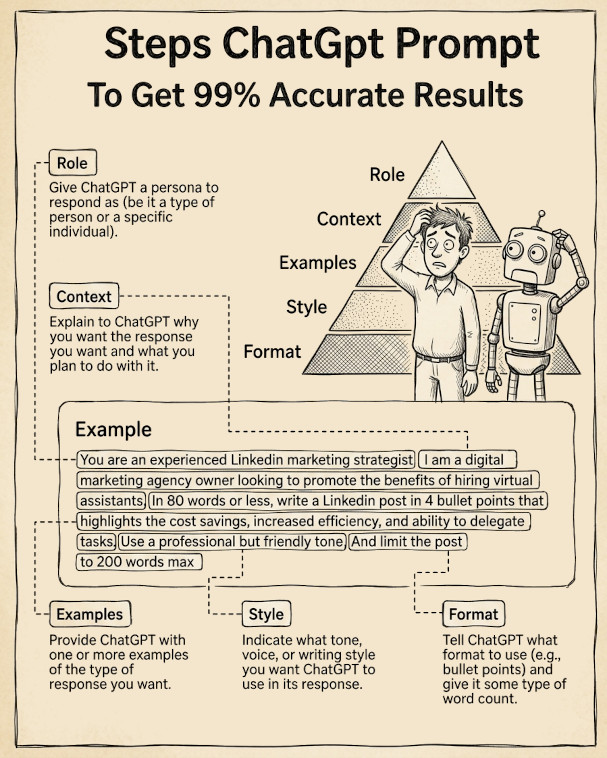
Tatăl meu era mecanic auto. Nu un mecanic de service, cu fișe de diagnoză și interfețe tactile, ci unul din aceia care diagnosticau un motor după sunet, după trepidația pe care o simțeau cu palma pe capotă, după mirosul de metal cald. Îl vedeam câteodată că se oprește în mijlocul unui lucru banal — strângea un șurub, curăța un filtru — și ținea cheia fixă un moment mai lung decât era necesar, ca și cum i-ar fi vorbit uneltei. Eram copil și mi se părea o ciudățenie. Acum înțeleg că era o formă de atenție. Unealta bună nu face nimic singură. Mâna care o ține trebuie să știe ce vrea.
Securea bună nu taie singură pădurea. Pentru 2026 este nuanțată expesia de intenția omului: delegare responsabilități.
M-am gândit la el prima dată când am realizat că primesc răspunsuri proaste de la ChatGPT nu pentru că modelul e slab, ci pentru că eu întrebam prost.
ChatGPT reprezintă o revoluție în modul în care interacționăm cu tehnologia și accesăm informația. Modelul său inovator permite utilizatorilor să formuleze cereri clare și detaliate pentru a obține răspunsuri elocvente. Prin intermediul unui prompt bine structurat, se pot obține explicații aprofundate și personalizate. Adaptabilitatea modelului asigură soluții eficiente pentru diverse întrebări și nevoi informaționale. Fiecare interacțiune reflectă importanța clarității și contextului oferit în cererea prompt.
Acest instrument devine tot mai indispensabil în era digitală datorită preciziei sale. Modelul de cerere prompt recomandat maximizează eficiența dialogului și acuratețea rezultatelor. Utilizatorii pot experimenta o comunicare fluentă și intuitivă prin utilizarea acestei tehnologii. Articolul explorează modul în care un prompt bine gândit transformă experiența de utilizare a ChatGPT. În final, se evidențiază impactul pozitiv al acestor practici în obținerea unui conținut de calitate și relevant.
„ChatGPT reprezintă o unealtă esențială în era digitală, oferind răspunsuri elocvente printr-o interpretare precisă a cererilor bine formulate.” Probabil interactiunea cu utilizatorul prin întrebări elocvente face difernța.
Modelul funcționează optim atunci când se utilizează principii precum claritatea, specificitatea și contextul complet. Structurarea promptului ajută la organizarea ideilor, facilitând obținerea unui răspuns coerent și bine definit. Exemplificarea și clarificarea așteptărilor modelează conținutul final în funcție de necesitățile utilizatorului. Întrebările de verificare contribuie la acuratețea și fundamentarea informațiilor furnizate. Toate aceste aspecte demonstrează că un prompt bine conturat este cheia unui dialog eficient cu tehnologia avansată. Această abordare transformă interacțiunea cu AI într-un proces interactiv și adaptativ. Utilizarea corectă a acestor tehnici aduce beneficii semnificative în accessarea și procesarea cunoștințelor. Astfel, modelul recomandat de cerere prompt devine indispensabil în obținerea unor răspunsuri informate și de calitate. În final, importanța acestor practici evidențiază rolul esențial al unei comunicări clare în maximizarea potențialului ChatGPT.
Ce este, de fapt, un prompt
Un prompt nu este o întrebare. Sau nu numai. Este un context, o direcție, o limită și o invitație — toate în același timp, comprimate în câteva propoziții pe care le trimiți unui model de limbaj care nu te cunoaște, nu știe în ce etapă a unui proiect ești, nu știe dacă ești obosit sau grăbit, nu știe că ai mai pus aceeași întrebare acum două săptămâni și ai primit un răspuns pe care l-ai șters.
Modelul primește exact ce îi transmiți. Nimic mai mult.
Asta e și problema, și soluția.
Cinci principii — și de ce contează fiecare
1. Claritatea nu e simplitate
Există o tendință, mai ales la început, să formulezi cereri scurte din convingerea că un model inteligent va completa el restul. Dar ChatGPT nu completează din înțelegere, completează din probabilitate. Dacă îi spui „scrie un articol despre AI", va scrie un articol decent, generic, fără personalitate — unul pe care l-ai putea găsi oriunde. A fost suficient de clar pentru a produce ceva. Dar nu a fost suficient de specific pentru a produce ceva util.
Claritatea înseamnă să nu lași loc ambiguității acolo unde ea poate fi eliminată. Nu „un articol", ci „un articol de 700 de cuvinte, ton analitic, pentru cititori familiarizați cu subiectul, fără introduceri inutile și fără concluzie care repetă introducerea."
Înainte:Scrie ceva despre importanța comunicării în echipă.
După:Scrie un eseu scurt (500 de cuvinte) despre modul în care comunicarea deficitară în echipele tehnice generează costuri ascunse. Ton direct, fără clișee motivaționale. Public țintă: manageri de proiect cu experiență.
2. Contextul transformă cererea
Există o diferență între a întreba și a situa întrebarea. Când îi spui unui model unde ești, ce faci, cu ce scop și pentru cine, îi dai cadrul în care răspunsul tău trebuie să existe.
Contextul util include: rolul pe care îl ceri modelului să îl adopte („acționează ca editor de text cu experiență în presă"), stadiul lucrului tău („am un draft, vreau să îmbunătățesc doar tranziția dintre secțiunea a doua și a treia"), constrângerile reale („nu pot modifica titlul, este deja publicat") și publicul final („cititorii sunt antreprenori cu activitate în România, fără formare tehnică").
Cu cât contextul e mai precis, cu atât modelul are mai puțin spațiu să improvizeze în direcții pe care nu le vrei.
3. Structura cererii organizează răspunsul
Dacă vrei un răspuns organizat, organizează și cererea. Nu e o regulă formală, e o consecință logică: modelul tinde să oglindească structura inputului.
O cerere structurată poate arăta simplu:
CONTEXT: [Cine ești, ce faci, pentru cine]
SARCINA: [Ce vrei concret]
FORMAT: [Cum vrei să arate răspunsul]
CONSTRÂNGERI: [Ce să evite, ce limite există]
Nu e nevoie să etichetezi fiecare secțiune, dar să le ai în minte când scrii face diferența dintre o cerere care primește un răspuns și una care primește răspunsul potrivit.
4. Exemplele valorează mai mult decât instrucțiunile
Dacă vrei un anumit ton, arată-l. Dacă vrei o anumită structură, dă un fragment. Modelele de limbaj învață din exemple cu o eficiență pe care instrucțiunile abstracte nu o ating.
„Scrie în stil jurnalistic" e o instrucțiune. „Scrie ca în primul paragraf din textul următor: [fragment]" e un exemplu. Al doilea produce rezultate mai consistente, pentru că elimină interpretarea.
Asta e tehnica pe care specialiștii o numesc few-shot prompting: oferi modelului câteva mostre din ce vrei, iar el calibrează răspunsul după ele.
5. Verificarea nu e neîncredere — e metodă
ChatGPT halucinează. Nu dintr-o intenție rea, ci structural: completează golurile cu ce pare plauzibil, nu cu ce e verificat. Dacă îi ceri date statistice, referințe, surse sau afirmații factuale, pune întotdeauna o întrebare de verificare sau cere explicit să marcheze incertitudinile.
„Dacă nu ești sigur de o dată sau un fapt, spune explicit că trebuie verificat" — această instrucțiune simplă reduce semnificativ riscul de a prelua ca adevărat ceva ce modelul a inventat cu convingere.
Șablon reutilizabil
Copiază, adaptează, folosește:
Acționează ca [rol / expert în domeniu].
Contextul meu: [situație, stadiu, scop].
Sarcina: [ce vrei concret, în termeni specifici].
Publicul final: [cine va citi/folosi răspunsul].
Format dorit: [lungime, structură, ton].
Constrângeri: [ce să evite, ce limite există].
Dacă nu ești sigur de vreo informație factuală, marchează-o explicit.
Checklist înainte de trimitere
Cinci secunde care schimbă calitatea răspunsului:
- [ ] Am specificat un rol sau o perspectivă?
- [ ] Am dat contextul necesar (ce fac, pentru cine, la ce etapă)?
- [ ] Am precizat formatul și lungimea dorită?
- [ ] Am oferit cel puțin un exemplu sau un fragment de referință?
- [ ] Am cerut să marcheze incertitudinile?
Cum s-a schimbat prompt engineering-ul (2020–2026)
Nu e un subiect static. Felul în care funcționează interacțiunea cu modelele de limbaj s-a transformat semnificativ în șase ani:
| Perioadă | Modele | Ce s-a schimbat în prompt engineering |
|---|---|---|
| 2020 | GPT-3 | Primele experimente zero-shot și few-shot; prompturile erau lungi și fragile |
| 2022–2023 | GPT-3.5 / ChatGPT | Popularizarea tehnicii Chain-of-Thought; apariția comunităților de prompting |
| 2024 | GPT-4o | Custom Instructions persistente, suport multimodal, System Prompts structurate |
| 2025–2026 | o1 / o3 / modele de tip reasoning | Modelele gândesc înainte să răspundă; prompturile clare câștigă mai mult ca oricând |
Schimbarea esențială din 2024–2026: modelele noi de tip reasoning (o1, o3) nu mai beneficiază la fel de mult de prompturi lungi și elaborate stilistic — beneficiază de prompturi clare, cu obiective precise și constrângeri explicite. Arta s-a deplasat de la retorică la precizie.
Prompt engineering pe domenii — câteva repere
Academic / cercetare: cere surse explicite, marchează obligatoriu incertitudinile, specifică standardul de citare dorit.
Marketing / copywriting: definește tonul brandului, publicul și platforma. Un prompt pentru LinkedIn nu e același cu unul pentru email sau articol de blog.
Dezvoltare software: cere cod comentat, specifică limbajul și versiunea, adaugă cerința de test cases. „Explică fiecare decizie de implementare" produce cod mai ușor de revizuit.
Business / analiză: cere structuri de raport predefinite, scenarizează explicit (what-if), limitează lungimea dacă vrei sumarizare, nu narațiune.
Limite, diferențe și ceea ce am învățat folosind ambele în producție
ChatGPT — și orice model de limbaj — este un instrument de amplificare, nu de substituire. Amplifică ce îi dai: dacă îi dai o întrebare vagă, amplifică vaguitatea. Dacă îi dai un context precis și o sarcină clară, amplifică precizia.
Tatăl meu nu cerea cheii fixe să repare motorul. Știa el ce trebuie reparat. Cheia era extensia mâinii lui, nu înlocuitorul minții lui.
Dar nu toate cheile sunt la fel. Și asta e o observație pe care am ajuns să o fac după câțiva ani de folosit modele diferite în muncă reală — nu în demonstrații, nu în experimente de weekend, ci în fluxuri de lucru unde un răspuns prost înseamnă timp pierdut și un text de refăcut de la capăt.
Reflexul de a fi de acord
ChatGPT are un reflex pe care, cu cât îl observi mai mult, cu atât te deranjează mai mult: tinde să fie de acord cu tine. Nu dintr-o convingere, ci dintr-un antrenament care a optimizat pentru satisfacția imediată a utilizatorului — aprobă, validează, continuă. Dacă îi prezinți o idee greșită cu suficientă încredere în voce, există șanse reale să o confirme înainte să o contrazică, dacă o contrazice vreodată.
Mecanicul cu care lucra tatăl meu nu ar fi tăcut niciodată dacă i-ai fi spus că problema e la alternator când era, evident, la curea de distribuție. Ar fi zis: nu, omule, ascultă motorul. Asta e diferența dintre un colaborator și un executant politicos.
Tiparul care se repetă
La reflexul de validare se adaugă o altă tendință, pe care am remarcat-o mai ales în lucrul pe texte lungi: răspunsurile au adesea o structură previzibilă, un tipar care se repetă indiferent de cerere — introducere, trei puncte echilibrate, concluzie care reia introducerea cu alte cuvinte. E util când vrei un schelet rapid. E limitativ când ai nevoie ca modelul să gândească problema din unghiul problemei, nu din unghiul unui format confortabil.
Nu e o critică absolută. Predictibilitatea are valoare în contexte unde vrei consistență — generare de rapoarte, extragere de date structurate, sarcini repetabile. Dar pentru muncă editorială, pentru analiză care cere nuanță, pentru texte unde vocea contează — tiparul devine zgomot.
Ce face diferit Claude
Prin contrast, în lucrul cu Claude — modelul dezvoltat de Anthropic — am observat câteva lucruri concrete, nu impresii.
Context mai lung, retenție mai bună. Claude procesează în mod standard ferestre de 200.000 de tokenuri și păstrează coerența până la capătul unui document lung. ChatGPT, cu o fereastră de ~128.000 de tokenuri, începe să piardă firul în structuri complexe după un anumit prag. Dacă lucrezi cu documentație tehnică extinsă, cu contracte, cu manuscrise sau cu codebaze mari, diferența se simte.
Mai puține halucinații în analiză documentară. Nu zero — niciun model nu e acolo — dar semnificativ mai puține în sarcini care implică documente reale, nu cunoștințe generale. Când îi dai un text și îi ceri să extragă, să verifice sau să compare, Claude tinde să rămână în text. ChatGPT uneori completează din ce știe el, nu din ce i-ai dat tu.
Rezistență mai mare la constrângeri complexe. Dacă îi impui un format strict — lungime exactă, structură fixă, restricții de ton — Claude urmărește instrucțiunile mai consistent, fără să negocieze tacit limitele pe care i le-ai pus.
Disponibilitatea de a rezista. Asta e, poate, diferența care contează cel mai mult în muncă editorială: Claude e mai dispus să spună că abordarea ta are o problemă, să reformuleze întrebarea în loc să execute mecanic cererea, să propună o direcție diferită când cea cerută e evident suboptimală. Nu e o chestiune de superioritate tehnică abstractă — e o chestiune de filozofie de produs: un model antrenat să fie util pe termen lung rezistă, uneori, pe termen scurt.
Când rămâne ChatGPT alegerea mai bună
Onestitatea cere să spun și asta. ChatGPT rămâne mai bun în câteva scenarii concrete: interacțiuni în timp real cu voce sau imagini, integrare în ecosisteme Microsoft și Azure, prototipare rapidă, brainstorming creativ unde varietatea stilistică contează mai mult decât precizia, și orice flux care beneficiază de ecosistemul lui extins de plugin-uri și tool-uri externe.
Nu există un model universal superior. Există contexte în care fiecare dintre ele face ceva mai bine.
O regulă practică
Dacă vrei să simplifici decizia: pentru volume mari de text structurat, analiză documentară și cod de producție — Claude. Pentru interacțiuni conversationale, multimodale sau integrate în ecosisteme enterprise existente — ChatGPT.
Și dacă lucrezi serios cu oricare dintre ele: niciun model nu înlocuiește verificarea umană. Validarea pe care o primești de la un model nu e întotdeauna un semn că ai dreptate. Uneori e doar un semn că modelul a optimizat pentru confortul tău în acel moment.
Întrebări frecvente
De ce primesc răspunsuri generice chiar și când cred că am întrebat ceva specific? Pentru că „specific" în capul tău și „specific" în prompt sunt, de regulă, două lucruri diferite. Ai în minte un întreg context pe care nu l-ai scris — cine ești, ce ai mai încercat, de ce nu a mers, pentru cine e textul, ce ton vrei să eviți. Modelul nu are nimic din toate astea dacă nu i le dai explicit. Adaugă rol, context, format, constrângeri. Și, dacă tot nu merge, pune întrebarea invers: ce lipsește din cererea mea pentru ca un om pe care nu îl cunoaște nimeni să poată răspunde corect la ea?
Cum evit halucinațiile — situațiile în care modelul inventează fapte cu toată convingerea? Nu le poți elimina complet, indiferent de model. Dar le poți reduce sistematic: cere surse explicite și instruiește modelul să marcheze orice afirmație despre care nu e sigur. Instrucțiunea „dacă nu ești sigur, spune-o" funcționează surprinzător de bine. Verifică independent orice cifră, dată, referință sau citat înainte să îl publici sau să îl folosești în ceva care contează. Regulă simplă: cu cât pare mai precis și mai convingător, cu atât merită verificat mai atent.
Ce fac dacă modelul ignoră o constrângere pe care i-am dat-o? Reformulează constrângerea ca interdicție explicită, nu ca preferință. „Scrie concis" e o preferință — modelul o interpretează. „Nu depăși 300 de cuvinte" e o regulă — modelul o urmărește. „Fără introducere generică" e mai eficient decât „fii direct". Limitele negative, concrete, sunt mai greu de ignorat decât calificativele pozitive și abstracte. Dacă tot nu funcționează, pune constrângerea și la începutul promptului, și la final — modelele acordă mai multă atenție extremelor.
ChatGPT sau Claude — care e mai bun pentru muncă editorială serioasă? Nu e o întrebare la care poți răspunde o dată pentru totdeauna, pentru că depinde de tipul muncii. Din experiența mea de lucru concret, pe texte lungi și sarcini editoriale: Claude urmărește constrângerile mai fidel, rezistă mai bine tentației de a valida ceea ce i se spune și pierde mai rar firul în conversații complexe. ChatGPT e mai rapid, mai flexibil stilistic și mai bine integrat în ecosisteme externe — e alegerea mai naturală pentru brainstorming, prototipare și orice necesită multimodalitate. Regula pe care o aplic eu: pentru execuție editorială unde precizia contează — Claude. Pentru explorare rapidă unde varietatea contează — ChatGPT.
De ce ChatGPT pare că îmi dă dreptate chiar și când greșesc? Pentru că a fost antrenat, în parte, să producă satisfacție imediată utilizatorului. E un efect secundar al metodei de antrenament bazate pe feedback uman — oamenii tind să evalueze mai bine răspunsurile care le confirmă ideile decât cele care le contrazic. Rezultatul e un model care, în absența unei instrucțiuni explicite de a rezista sau de a critica, alege mai degrabă acordul. Soluția practică: cere explicit contraargumentele. „Care sunt cele mai bune trei obiecții la această abordare?" produce mai mult decât „ce crezi despre această abordare?"
Contează ordinea în care pun informațiile în prompt? Da, și mai mult decât s-ar crede. Modelele acordă atenție sporită începutului și sfârșitului unui prompt — mijlocul e zona cu cel mai mare risc de a fi tratat superficial în cererile lungi. Pune sarcina principală la început, contextul și exemplele la mijloc, constrângerile critice la final. Dacă ai o instrucțiune pe care nu îți permiți să fie ignorată, repetă-o în ambele locuri — nu e redundanță, e arhitectură.
Mă gândesc la bibliografie cum mă gândeam, copil, la lista de ingrediente de pe spatele unui borcan: știam că e acolo ceva important, dar nu înțelegeam exact de ce trebuie citit cu atenție până când nu am mâncat ceva care nu-mi era bine.
Bibliografie online
surse relevante pentru subiectul articolului
Despre prompting și interacțiunea cu modelele de limbaj
Anthropic. Prompt engineering overview. Documentație oficială. https://docs.anthropic.com/en/docs/build-with-claude/prompt-engineering/overview
OpenAI. GPT best practices — Prompt engineering guide. https://platform.openai.com/docs/guides/prompt-engineering
Learn Prompting. The open-source prompt engineering guide. https://learnprompting.org
White, J. et al. (2023). A Prompt Pattern Catalog to Enhance Prompt Engineering with ChatGPT. arXiv preprint. https://arxiv.org/abs/2302.11382
Despre limitele modelelor de limbaj — halucinații, validare, bias
Anthropic. Claude's model specification — Values, honesty, and avoiding sycophancy. https://www.anthropic.com/research/model-specification
Ji, Z. et al. (2023). Survey of Hallucination in Natural Language Generation. ACM Computing Surveys. https://dl.acm.org/doi/10.1145/3571730
Perez, E. et al. (2022). Red Teaming Language Models with Language Models. arXiv. https://arxiv.org/abs/2202.03286
Despre few-shot prompting și structura cererilor
Brown, T. et al. (2020). Language Models are Few-Shot Learners. NeurIPS. arXiv. https://arxiv.org/abs/2005.14165
Reynolds, L. & McDonell, K. (2021). Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm. arXiv. https://arxiv.org/abs/2102.07350
Despre sycophancy și reflexul de validare al modelelor
Anthropic. Sycophancy: How AI models learn to tell us what we want to hear. https://www.anthropic.com/research/sycophancy-to-subterfuge-investigating-reward-tampering
Perez, E. et al. (2022). Discovering Language Model Behaviors with Model-Written Evaluations. arXiv. https://arxiv.org/abs/2212.09251
Comparații între modele — contexte de utilizare
Liang, P. et al. (2022). Holistic Evaluation of Language Models (HELM). Stanford CRFM. https://crfm.stanford.edu/helm/latest/
Anthropic. Claude vs. GPT — context window and document analysis. Model documentation. https://docs.anthropic.com/en/docs/about-claude/models/overview
Notă de onestitate: unele dintre linkurile de mai sus — în special cele spre arXiv — duc spre lucrări academice pe care un cititor obișnuit le va parcurge diagonal și le va închide după primul paragraf plin de notații matematice. Le includ totuși, pentru că sursa contează chiar și când lectura completă e improbabilă. Documentele Anthropic și ghidurile OpenAI sunt, în practică, cele mai utile pentru cineva care lucrează efectiv cu modelele. Restul e stratul de legitimitate care dovedește că subiectul are substanță dincolo de articolele de blog.
Notă a autorului
limite, tensiuni, unelte retorice
Articolul acesta are un defect structural pe care nu îl pot ascunde cu bună-credință: a pornit dintr-un draft vechi, scris într-o perioadă când știam mai puțin despre cum funcționează modelele de limbaj și când îmi permiteam un optimism pe care acum îl citesc cu jenă. Paragrafele din prima secțiune — cele cu „revoluție", „indispensabil", „comunicare fluentă și intuitivă" — nu sunt ale mele în sensul propriu-zis. Sunt ale unui draft pe care l-am rafinat, dar nu suficient. Le-am lăsat acolo pentru că ștergerea lor completă ar fi însemnat să pretind că am scris altfel de la început. Nu am scris.
Ceea ce am scris cu adevărat începe de la tatăl meu și de la cheia fixă. Asta e ancorarea reală a textului. Restul — principiile, structura, comparația dintre modele — vine din experiență de lucru concretă, nu din entuziasm de prezentare.
Tensiunea principală pe care o resimte oricine scrie despre unelte AI în 2026 este că îți publici textul la câteva luni după ce l-ai scris, și în intervalul ăla se schimbă versiunile, se schimbă comportamentele, se schimbă inclusiv ceea ce ai observat că e adevărat. Secțiunea despre Claude și ChatGPT reflectă observații din lucru real, dar din lucru real de la un anumit moment. Ferestrele de context s-au schimbat de atunci. Reflexul de validare al ChatGPT s-a mai atenuat, cel puțin în unele configurații. Nu am actualizat fiecare cifră și fiecare comparație — asta ar face din articol o versiune perpetuu editată, fără niciun moment de stabilitate.
Am ales să las comparația ca document al unui moment, nu ca referință actualizată. Cine citește în 2026 și lucrează serios cu modele știe că orice comparație de acest gen are o dată de expirare.
Uneltele retorice pe care le-am folosit conștient:
Metafora tatălui mecanic nu e ornament. E structura argumentului. Tot ce urmează — claritate, context, constrângeri, exemplificare — e o formă de a spune același lucru: unealta nu gândește pentru tine. Am repetat-o la final, cu cheia fixă, tocmai pentru că structura circulară e mai sinceră decât concluzia care adaugă ceva nou. Nu am adăugat nimic nou la final. Am închis cercul.
Comparația directă cu Claude e un risc editorial asumat. Există o ciudățenie evidentă în a scrie pe un site personal un paragraf laudativ despre modelul cu care ai scris, de fapt, cea mai mare parte a textului — și pe care îl folosești drept mediu de lucru principal. Conflictul de interese e real și îl declar explicit: am un bias format din experiență de lucru, nu din neutralitate testată metodic. Nu am făcut benchmark-uri controlate. Am observat comportamente în fluxuri reale și le-am raportat ca atare.
Secțiunea de FAQ e construită din întrebările pe care mi le-am pus eu înainte să le pună alții. Nu e un exercițiu de SEO — sau nu numai. E și o formă de a pune pe hârtie ceea ce rămâne nerezolvat după ce ai terminat de scris articolul principal.
Limita fundamentală a textului e aceasta: explică cum să ceri bine, dar nu poate garanta că ceea ce obții e adevărat. Prompting-ul bun reduce zgomotul, nu elimină eroarea. Iar asta e o distincție pe care articolul o atinge, dar nu o apasă suficient. Ar fi trebuit să fie mai apăsată.