


De ce AI-ul nu „citește" așa cum citești tu. 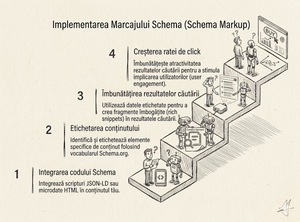 Există o iluzie confortabilă în care trăiesc mulți dintre cei care publică pe web: că un text bine scris va fi, prin forța lui proprie, înțeles. Că dacă spui ceva adevărat și îl spui clar, lumea — inclusiv lumea mașinilor — va pricepe. M-am aflat și eu în această iluzie un timp, scriind, publicând, așteptând. Până când am înțeles că mașinile nu citesc. Ele procesează.
Diferența este mai mare decât pare. Când citești, aduci cu tine context, memorie, emoție, inferență. Știi că „Primăria din Botoșani" înseamnă o instituție locală, că „program de lucru" se referă la orele de audiență, că autorul textului este o persoană și nu o entitate abstractă. Un sistem AI, dacă nu i se spune explicit, ghicește. Uneori ghicește bine. Alteori te transformă în altceva decât ești.
Datele nestructurate — text simplu, imagini, video — sunt accesibile oamenilor, dar dezordonate pentru mașini. Modelele AI au nevoie de date etichetate și structurate ca să le poată analiza, categoriza și folosi în răspunsuri. Fără această etichetare, conținutul tău există în traducere automată — și traducerea poate fi greșită.
Schema markup este răspunsul la această problemă. Nu un truc SEO, nu un hack tehnic de weekend. Este limbajul prin care îi spui mașinii: „Aceasta este o organizație. Acesta este autorul. Aceasta este o întrebare și acesta este răspunsul ei." Este, dacă vrei o metaforă mai umană, diferența dintre a-ți prezenta tatăl cuiva care îl vede pentru prima dată — „acesta este tata, mecanic, om al concretului" — și a-l lăsa să fie interpretat după cum îl percepe fiecare.
Ce este Schema Markup — vocabularul pe care îl înțelege AI-ul
Originea și legitimitatea vocabularului
Schema.org nu este produsul unui singur actor de piață. A fost creat în 2011 printr-un acord rar între Google, Microsoft, Yahoo și Yandex — patru competitori care au ales să construiască împreună un limbaj comun pentru web. Vocabularul acesta descrie entități: persoane, organizații, produse, articole, evenimente, locuri, întrebări și răspunsuri. Este standardul de facto al webului semantic.
Mai mult decât atât, Microsoft a anunțat NLWeb, o inițiativă deschisă condusă chiar de RV Guha, creatorul schema.org, construită pe date structurate, care permite interfețe conversaționale AI prin care utilizatorii și agenții AI pot interoga conținutul site-ului în limbaj natural. Asta înseamnă că infrastructure pe care o construiești azi cu schema markup nu servește doar căutarea de mâine — servește webul agențial care se conturează la orizont.
Confirmările oficiale din 2025
Dacă până în 2024 utilitatea schemei pentru AI era în parte speculativă, 2025 a adus confirmări publice. Atât Google cât și Microsoft au declarat oficial că folosesc Schema Markup pentru funcționalitățile lor de AI generativ — Google spunând explicit că datele structurate sunt critice pentru căutarea modernă deoarece sunt eficiente, precise și ușor de procesat de mașini. Nu sugestii, nu bune practici opționale. Infrastructură declarată.
Concret: Fabrice Canel, principal product manager la Microsoft Bing, a confirmat în martie 2025 că schema markup ajută modelele LLM ale Microsoft să înțeleagă conținutul pentru Copilot. Iar ChatGPT a confirmat că folosește date structurate pentru a determina ce produse apar în rezultatele sale. Ecosistemul AI a votat: dacă vrei să fii citat, trebuie să fii structurat.
Formatele disponibile: alegerea nu este dramatică, dar contează
Există trei formate pentru date structurate: Microdata, RDFa și JSON-LD. Microdata și RDFa se împletesc cu HTML-ul vizibil — orice modificare de template riscă să spargă markup-ul. JSON-LD este inserat ca un bloc <script> separat, nu atinge HTML-ul tău, poate fi generat programatic dintr-un CMS și este formatul pe care Google îl recomandă explicit.
Dacă lucrezi în Joomla — și eu lucrez în Joomla de opt ani — JSON-LD este singura alegere rațională. Îl poți injecta dintr-un plugin de sistem, îl poți modifica fără să atingi template-ul, îl poți versiona separat. Este, tehnic vorbind, îngrijit.
Cum funcționează — de la cod la citat AI
Entități, atribute, relații
Gândește-te la o pagină web ca la o afirmație: „Această pagină vorbește despre X." Schema markup transformă această afirmație vagă în ceva precis: „Această pagină este un articol de tip BlogPosting, scris de autorul Petru Cojocaru, publicat pe data de 30 iulie 2025, parte a categoriei Realizare site-uri, aparținând organizației cojocarupetru.info." Fiecare proprietate este o relație. Relațiile formează o rețea.
Schema markup permite site-urilor să identifice clar entități importante — produse, servicii, branduri, persoane, locații — și să explice cum aceste entități se relaționează între ele, eliminând confuzia pentru sistemele AI. Fără markup, AI-ul inferează. Cu markup, AI-ul știe.
De la rich results la semnal de încredere
Timp de ani, schema markup a fost discutată mai ales în termeni de „rich results" — acele fragmente vizuale din Google cu stele, prețuri, breadcrumbs. Dar lumea s-a schimbat. Google AI Mode — alimentat de Gemini — utilizează schema markup pentru a verifica afirmații, a stabili relații între entități și a evalua credibilitatea sursei în timpul sintezei răspunsurilor. AI Mode nu afișează schema ca rich result: o citește ca să înțeleagă despre ce este pagina, cine a scris-o, dacă merită să fie citată.
Aceasta este schimbarea de paradigmă pe care o simt în propriul meu mod de a construi site-uri. Nu mai optimizez pentru o afișare vizuală în SERP. Optimizez pentru a fi înțeles corect de un sistem care va decide, în câteva milisecunde, dacă informația mea merită să ajungă la om.
Graful de cunoaștere intern — identitatea ta digitală coerentă
Când schema este implementată cu valori stabile @id și o structură @graph, începe să se comporte ca un mic graf intern de cunoaștere: AI-ul nu mai trebuie să ghicească cine ești și cum se leagă conținutul tău, putând urma conexiunile explicite între brand, autori și subiecte. Asta înseamnă că fiecare articol pe care îl scrii, legat corect de autorul său, de organizația sa, de topicul său, construiește o identitate digitală coerentă. Nu un set de pagini disparate, ci o voce recognoscibilă.
Și mai departe, când datele sunt conectate pe întregul site, ele formează un Content Knowledge Graph — un strat de date citibil de mașini care arată cum se relaționează conținutul, brandul și ofertele unei organizații. Grafuri de cunoaștere nu sunt privilegiul Wikipedia sau Google. Le poți construi pe propriul domeniu, cu răbdare și metodă.
Tipurile de schemă cu impact maxim în citările AI
FAQPage — răspunsul direct
Acesta este tipul de schemă pe care îl înțeleg imediat și clienții de instituții publice când le explic: o întrebare și un răspuns, marcate semantic. Sistemele AI analizează schema FAQPage pentru a extrage răspunsuri concise care corespund direct interogărilor utilizatorilor — răspunsurile ideale au între 40 și 60 de cuvinte, iar schema FAQPage îmbunătățește ratele de citare AI cu 30% în medie. Dacă ai o pagină de tipul „Cum se depune o cerere de autorizație" sau „Care sunt documentele necesare", FAQPage este alegerea evidentă.
HowTo — instrucțiunea structurată
Schema HowTo structurează instrucțiunile pas cu pas într-un format pe care AI-ul îl poate procesa și cita cu ușurință. Dacă o pagină de prezentare a unui serviciu conține și un ghid de utilizare — pași numerotați, acțiuni concrete — HowTo markup transformă acel conținut din text oarecare în instrucțiune formală, citabilă, refolosibilă în răspunsuri AI.
Article, Person, Organization — autoritatea autorului
Tipurile cheie de schemă pentru conținut editorial includ Article, Person și Organization. Legarea unui articol de autorul său printr-un obiect Person explicit — cu proprietăți sameAs care indică spre profiluri verificabile: LinkedIn, Wikidata, alte site-uri ale aceluiași autor — transformă un text anonim în conținut atribuibil. Și conținutul atribuibil are mai multă greutate în evaluarea AI.
Prin referencing la autorități externe ca Wikipedia sau Wikidata, construiești o rețea de încredere. Aceasta se numește semantic linking și este diferența dintre un nod izolat și un nod conectat în graful webului.
BreadcrumbList — navigația ca semnal de context
Un detaliu pe care mulți îl omit: BreadcrumbList nu este doar pentru utilizatori. Întărește navigația site-ului atât pentru căutare, cât și pentru înțelegerea maşinală. Când AI-ul vede că un articol aparține categoriei „Realizare site-uri" → subcategoriei „Optimizare AI" → domeniului „cojocarupetru.info", înțelege contextul editorial fără să facă inferențe. Contextul este explicit. Explicit este mai bun.
Abordarea holistică — dincolo de JSON-LD în header
HTML semantic ca fundament
Există o greșeală frecventă pe care o văd în site-urile pe care le preiau spre restructurare: JSON-LD adăugat corect, dar HTML-ul vizibil haotic. <div> peste <div>, texte importante ascunse în structuri anonime, heading-uri H2 folosite pentru efect vizual în loc să marcheze ierarhia conținutului. Un sistem AI citește și HTML-ul, nu doar scriptul de date structurate.
Tag-urile <header>, <nav>, <main>, <article>, <section> nu sunt decorațiuni — sunt semnale semantice. Ierarhia H1–H2–H3 nu este o chestiune de estetică — este logica textului expusă formal, urmată literalmente de crawler. Un H2 care spune „De ce să alegeți serviciile noastre" și sub el cinci H3 cu beneficii concrete comunică mașinii exact aceeași structură pe care o comunică omului: o teză și argumentele ei.
Conținut structurabil vs. conținut fluid
Nu orice text trebuie transformat în schemă. Există conținut narativ — eseul, povestea, argumentul lung — care nu se pretează la etichetare rigidă și nici nu ar trebui forțat. Există conținut factual — servicii, contacte, procese, întrebări frecvente — care câștigă enorm din structurare. Discernerea dintre cele două este o abilitate, nu un algoritm. O primărie are nevoie de GovernmentOrganization, LocalBusiness, OpeningHoursSpecification. Un eseu filozofic are nevoie de Article și Person. Fiecare tip de conținut are schema lui potrivită.
Capcana abuzului — ce nu trebuie făcut
Actualizarea de bază Google din martie 2026 a redus afișarea rich result pentru mai multe tipuri de schemă care fuseseră abuzate pe scară largă, inclusiv FAQ, Review și How-To pe pagini unde nu constituiau conținutul principal. Site-urile care au implementat schema aliniată la intenția autentică a conținutului și-au menținut sau chiar îmbunătățit ratele de rich result.
Asta înseamnă că schema pusă pe pagini unde nu are ce căuta — FAQ markup pe o pagină de prezentare care nu conține nicio întrebare reală, Review markup fabricat — nu mai este o scurtătură. Este un risc. Schema trebuie să descrie ce există, nu ce vrei să pari că ai.
Cazul specific: firme și instituții publice românești
Ce date structurate contează pentru primării, spitale, școli
Lucrez de ani buni cu instituții publice românești: primării, consilii județene, spitale, școli. Acestea au un profil de nevoie specific: oamenii caută program de lucru, adrese, contacte, servicii oferite, proceduri administrative. Tocmai aceste informații sunt cel mai ușor de structurat și cel mai greu de găsit în prezent, pentru că nimeni nu le-a marcat semantic.
Tipurile relevante sunt GovernmentOrganization pentru instituții publice, MedicalOrganization pentru spitale și clinici, EducationalOrganization pentru școli. La acestea se adaugă proprietăți concrete: openingHoursSpecification pentru program de lucru, address cu toate câmpurile completate, contactPoint cu telefon și email, hasOfferCatalog pentru serviciile oferite. Informații care există pe site — uneori — dar care sunt invizibile pentru AI pentru că niciun sistem nu le-a spus mașinii ce sunt.
Diferența dintre a fi citat și a fi ignorat
Cifrele sunt directe: site-urile cu date structurate corect implementate sunt citate în răspunsurile AI de 3,2 ori mai des decât cele fără, iar conținutul cu schema markup adecvat are o șansă de 2,5 ori mai mare să apară în răspunsurile generate de AI. Raportat la o instituție publică, asta înseamnă că un cetățean care întreabă un asistent AI „Care este programul de lucru al Primăriei din Botoșani?" va primi răspunsul corect dacă datele sunt structurate — sau va primi tăcere, redirecționare, sau o informație veche extrasă greșit dintr-o pagină fără markup.
Nu este o chestiune estetică. Este funcționalitate. Instituțiile care înțeleg asta vor fi prezente. Cele care nu, vor fi înlocuite în răspunsurile AI de pagini terțe care le descriu — corect sau nu.
Implementare practică în Joomla
Joomla are câteva plugin-uri care adaugă JSON-LD la nivel de componentă. Niciuna dintre soluțiile disponibile public nu acoperă toată granularitatea de care ai nevoie pentru instituții publice — de aceea, în practica mea, generez blocuri JSON-LD personalizate direct în template, prin override-uri de layout, sau prin plugin-uri de sistem custom. Validarea se face cu Google Rich Results Test (search.google.com/test/rich-results) și cu Schema Markup Validator (validator.schema.org). Nu publici fără validare — orice proprietate greșită sau lipsă poate invalida întregul bloc.
Măsurare și verificare — cum știi că funcționează
Instrumentele de verificare imediată
Înainte să măsori impact, verifici corectitudinea. Procesul este simplu și nu cere expertiză avansată:
Google Rich Results Test (search.google.com/test/rich-results) — analizează o URL sau un fragment de cod și îți spune dacă schema este validă, ce rich results ești eligibil să obții, și ce proprietăți lipsesc. Erorile sunt clasificate în critice (markup invalid) și avertismente (proprietăți opționale absente).
Schema Markup Validator (validator.schema.org) — instrumentul oficial schema.org, mai permisiv decât cel Google, util pentru a verifica tipuri de schemă care nu apar în Google Rich Results Test.
Google Search Console — secțiunea Enhancements îți arată, în timp, câte pagini sunt eligibile pentru rich results, câte au erori, și tendința pe săptămâni. Este singura sursă de date reale despre cum vede Google markup-ul tău în producție.
Monitorizarea citărilor în platformele AI
Google Search Console nu arată citările din AI Mode sau din ChatGPT. Pentru acestea, monitorizarea este manuală sau semi-automată: interogări directe în ChatGPT, Perplexity, Google AI Overviews cu întrebări la care ar trebui să apari ca sursă. Există și instrumente terțe (Semrush AI Toolkit, Ahrefs AI Visibility) care încep să tracked AI citations, dar piața acestor instrumente este încă în formare.
Ce pot spune din practică: după implementarea corectă a FAQPage schema pe paginile de servicii, apar citări în Perplexity în câteva săptămâni. Nu garantat, nu pentru orice subiect, dar vizibil mai des decât înainte.
Concluzie: Infrastructură, nu truc
Schema markup este infrastructură, nu un glonț magic. Nu garantează neapărat mai multe citări, dar este unul dintre puținele lucruri pe care le poți controla pe care platformele precum Bing și Google AI Overviews le utilizează explicit. Oportunitatea reală nu stă în schemă izolat, ci în combinația dintre date structurate, relații corecte între entități, conținut de calitate și autoritate tematică, identitate clară a entității și semnale de brand, și folosirea strategică a @graph și @id pentru a construi conexiuni între entități.
Tatăl meu repara motoare. Îi aducea cineva o mașină cu motor strâns, el deschidea capota și întreba: „Ai actele ei?" Nu pentru birocrație — pentru că actele spuneau ce a mai pățit motorul, ce a mai fost schimbat, cine a mai lucrat la el. Fără acte, pornea de la zero, ghicind. Cu acte, lucra informat.
Schema markup sunt actele site-ului tău. Nu îl fac mai bun decât este — dar fac ca tot ce este bun în el să fie înțeles corect, să nu fie ghicit, să nu fie transformat în altceva de o mașină care face tot ce poate din ce îi dai.
Dă-i mașinii ce are nevoie ca să te înțeleagă. Restul este treaba ei.
10 Întrebări cu răspuns elocvent de memorat
Ce este Schema markup și de ce contează pentru AI? Schema markup este un vocabular standardizat de metadate — creat prin acord între Google, Microsoft, Yahoo și Yandex — care permite site-urilor să descrie explicit entitățile conținutului lor: persoane, organizații, produse, întrebări, instrucțiuni. Contează pentru AI pentru că sistemele generative nu deduc sens din context la fel cum o fac oamenii — ele au nevoie de etichete clare. Fără markup, AI-ul ghicește ce ești. Cu markup, știe.
Care este diferența dintre Microdata, RDFa și JSON-LD? Microdata și RDFa se integrează în HTML-ul vizibil al paginii — orice modificare de template riscă să spargă markup-ul. JSON-LD este un bloc <script> separat, nu atinge HTML-ul vizibil, poate fi generat programatic și este formatul recomandat explicit de Google. Dacă lucrezi cu un CMS (Joomla, WordPress, Drupal), JSON-LD este singura alegere care rezistă la upgrade-uri de template.
Google și Microsoft confirmă că folosesc schema markup pentru AI? Da. În martie 2025, Google a declarat că datele structurate sunt critice pentru căutarea modernă — eficiente, precise și ușor de procesat de mașini. Microsoft Bing a confirmat că schema ajută LLM-urile lor să înțeleagă conținut pentru Copilot. ChatGPT a confirmat că folosește date structurate pentru a determina ce produse apar în rezultate. Nu mai este speculație — este infrastructură confirmată.
Ce este un Content Knowledge Graph și cum îl construiești? Un Content Knowledge Graph este un strat de date conectate care descrie toate entitățile unui site și relațiile dintre ele: autori, articole, categorii, organizație, servicii. Se construiește prin utilizarea proprietăților @id și @graph în JSON-LD, prin legarea consecventă a autorilor de articole și a articolelor de categorii, și prin referencing spre entități externe verificabile (Wikidata, Wikipedia). Nu se construiește dintr-o dată — se acumulează articol cu articol, pagină cu pagină.
Care sunt tipurile de schemă cu impact maxim în citările AI? FAQPage (crește rata de citare AI cu ~30%, răspunsuri de 40-60 cuvinte), HowTo (instrucțiuni pas cu pas), Article cu Person (atribuie conținut unui autor verificabil), Organization/LocalBusiness (identifică entitatea), BreadcrumbList (contextualizează pagina în structura site-ului). Pentru instituții publice: GovernmentOrganization, MedicalOrganization, EducationalOrganization cu proprietăți de contact și program de lucru.
Poate schema markup să te penalizeze dacă o implementezi greșit? Da. Actualizarea Google din martie 2026 a redus rich results pentru site-uri care implementau FAQ, Review sau HowTo pe pagini unde acel tip de conținut nu era prezent în realitate — markup folosit ca manipulare a SERP-ului. Regula simplă: schema descrie ce există pe pagină, nu ce vrei să pari că ai. Markup corect pe conținut autentic — niciun risc. Markup fabricat sau dezaliniat de conținut — risc real de penalizare.
De câte ori mai des sunt citate în AI site-urile cu schema față de cele fără? Studiile din 2025-2026 indică că site-urile cu date structurate corect implementate sunt citate în răspunsurile AI de 3,2 ori mai des. Conținutul cu schema adecvat are o șansă de 2,5 ori mai mare să apară în răspunsuri AI generative. Paginile cu FAQPage schema specifică cresc cu ~30% rata de citare față de aceleași pagini fără markup.
Cum verifici că schema ta funcționează corect? Trei instrumente esențiale: Google Rich Results Test (search.google.com/test/rich-results) — validare imediată a oricărei URL, clasifică erori critice și avertismente; Schema Markup Validator (validator.schema.org) — validare oficială schema.org, mai permisivă, utilă pentru tipuri neprelucrate de Google; Google Search Console → secțiunea Enhancements — date de producție, tendință în timp, număr de pagini eligibile vs. pagini cu erori. Nicio pagină nu se publică fără validare prealabilă.
Ce tipuri de schemă sunt prioritare pentru o primărie sau spital românesc? GovernmentOrganization sau MedicalOrganization ca tip principal al entității, cu address complet, contactPoint (telefon, email), openingHoursSpecification pentru program de lucru, hasOfferCatalog pentru serviciile oferite. FAQPage pe paginile de ghiduri și proceduri administrative. BreadcrumbList pe toate paginile. Article cu Person pe fiecare comunicat sau știre. Aceste informații sunt exact cele pe care cetățenii le caută în asistenți AI — dacă nu sunt structurate, răspunsul va fi greșit sau absent.
Schema markup este suficientă pentru vizibilitate AI? Nu. Schema este infrastructură necesară, nu suficientă. Impactul real vine din combinarea datelor structurate cu: conținut de calitate și autoritate tematică demonstrabilă, identitate clară a entității și semnale de brand consistente pe toate platformele, relații corecte între entități (@graph, @id, sameAs), și conținut autentic aliniat cu tipul de schemă folosit. Schema fără conținut valoros este o etichetă pe o cutie goală — AI-ul, la fel ca oricine altcineva, deschide cutia.
Bibliografie online
-
SerpZilla — Schema Markup for AI Search in 2026 | Structured Data for Better AI Visibility https://serpzilla.com/blog/schema-markup-ai-search/ (accesat mai 2025)
-
Search Engine Land — How schema markup fits into AI search — without the hype https://searchengineland.com/schema-markup-ai-search-no-hype-472339 (publicat martie 2026)
-
SchemaApp — What 2025 Revealed About AI Search and the Future of Schema Markup https://www.schemaapp.com/schema-markup/what-2025-revealed-about-ai-search-and-the-future-of-schema-markup/ (publicat ianuarie 2026)
-
Medium / Vicki Larson — How Structured Data Schema Transforms Your AI Search Visibility in 2026 https://medium.com/@vicki-larson/how-structured-data-schema-transforms-your-ai-search-visibility-in-2026-9e968313b2d7 (publicat februarie 2026)
-
Digital Applied — Schema Markup After March 2026: Structured Data Update https://www.digitalapplied.com/blog/schema-markup-after-march-2026-structured-data-strategies (publicat martie 2026)
-
Stackmatix — Structured Data AI Search: Schema Markup Guide (2026) https://www.stackmatix.com/blog/structured-data-ai-search (publicat martie 2026)
-
Wellows — Schema & NLP Best Practices for AI Search Visibility (2026 Guide) https://wellows.com/blog/schema-and-nlp-best-practices-for-ai-search/ (publicat martie 2026)
-
LangSync AI — Structured Data AI Search: Schema Markup & Best Practices for AI Models https://blog.langsync.ai/structured-data-ai-search-schema-guide/ (publicat decembrie 2025)
-
Ignite Visibility — What Is JSON-LD Structured Data & Why Do You Need It? https://ignitevisibility.com/everything-to-know-about-json-ld-for-seo/ (actualizat 2026)
-
Schema Pilot — JSON-LD: The Complete Guide to Structured Data in 2026 https://www.schemapilot.app/blog/json-ld-guide/ (publicat martie 2026)
-
Search Engine Zine — JSON-LD For Beginners: The Authority Guide To Structured Data Architecture https://searchenginezine.com/technical/schema/json-ld-for-beginners/ (publicat februarie 2026)
-
schema.org — Vocabularul oficial https://schema.org/
-
Google Developers — Understand how structured data works https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data
Nota autorului
Tensiuni asumate în acest text
Există o tensiune pe care am simțit-o scriind fiecare secțiune și pe care nu am rezolvat-o, ci am ales s-o las vizibilă: aceea dintre logica tehnocratică a structurării și logica organică a scrisului autentic. Schema markup îți cere să etichetezi, să categorisești, să reduci la proprietăți formale. Scrisul bun — cel din eseu, din confesiune, din argumentul lung — refuză tocmai această reducere. Am scris articolul acesta ca pe un text funcțional, nu ca pe un eseu. Știu diferența. Dacă ar fi după mine, aș fi scris eseu. Dar instituțiile publice nu au nevoie de eseuri — au nevoie de pagini de servicii cu program de lucru marcat corect.
A doua tensiune: am recomandat instrumente și practici cu cifre concrete (3,2x mai multe citări, 30% mai mult pentru FAQPage) provenite din studii ale unor companii care vând soluții de schema markup sau SEO. Există un conflict de interese structural în aceste cifre — nu le-am putut verifica independent, și orice lectură onestă trebuie să le trateze ca indicatori direcționali, nu ca date verificate academic.
Comparații și unelte retorice
Am folosit în mod deliberat comparația cu actele mașinii — moștenită din vocabularul tatălui meu, mecanic toată viața. Nu este o figură de stil accidentală: ea traduce o logică abstractă (metadate, entități, grafuri) într-un registru concret, reparatoriu, al omului care lucrează cu lucruri reale. Mașina nu merge fără acte — schema markup nu funcționează fără conținut real. Analogia are limite: actele unei mașini sunt fixe, schema unui site este un organism viu care trebuie actualizat.
Am folosit și interogația retorică în câteva locuri (de ce AI-ul nu „citește" cum citești tu?) nu ca procedeu ornamental, ci ca invitație la suspendarea presupunerii că mașinile gândesc ca oamenii. Această presupunere este sursa celor mai frecvente greșeli pe care le văd în site-urile pe care le preiau.
Limite ale articolului
Articolul nu acoperă: implementarea Joomla pas cu pas (merită articol separat cu cod real), schema pentru e-commerce românesc (Produse, Oferte, Recenzii — altă complexitate), aspectele juridice ale markup-ului (datele structurate pot fi utilizate de AI fără atribuire — o problemă de drepturi de autor nerezolvată în dreptul european), și limitele recunoscute ale schemei pentru conținut narativ/filozofic unde etichetarea forțată distorsionează sensul.
Limitele nu sunt scuze. Sunt invitații spre articolele care urmează.